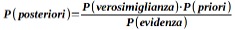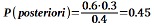Hume PageHume Page

L’IA funziona. Che significa?

23 Ottobre 2026 - di Renato Miceli

In primo pianoPoliticaSocietà

Questo argomento emerse tempo addietro discorrendo con la collega Silvia Testa,
a margine di alcuni incontri rivolti alla stesura di un articolo di lavoro, di tutt’altra materia.
Avevamo idee diverse. Promisi, allora, che avrei tentato di chiarire il mio punto di vista.
Purtroppo, la collega è improvvisamente e prematuramente scomparsa.
A lei, al suo ricordo, dedico questo scritto.

In un articolo [1] di alcuni anni fa ho cercato di:
(i) illustrare i legami fra IA e Analisi dei Dati;
(ii) spiegare come può essere realizzato uno strumento (semplice) di IA, tramite un’applicazione informatica che emula un Classificatore Bayesiano Naif;
(iii) riflettere sui pregi, limiti e pericoli insiti nell’utilizzo di tecnologie di questo tipo.

In particolare, per quanto riguarda l’ultimo aspetto, ho posto in evidenza come: <<nelle applicazioni dell’IA, chi governa il processo inerente i dati, più che la realizzazione degli algoritmi, ha enormi responsabilità sociali, può manipolare – come mai prima d’ora – l’ideologia degli individui>>.
Ho inoltre segnalato che: <<disgraziatamente l’assenza di informazioni su come vengono gestiti i dati sembra essere la norma, ancora più stringente della segretezza imposta su alcuni algoritmi>>.
A tale proposito, desidero raccontare un aneddoto.
Pensai di inoltrare l’articolo di cui sopra ad un amico, per raccogliere il suo parere su quanto da me scritto. Non avendo intenzione di leggerlo, l’amico decise di sottoporre il testo a ChatGPT, chiedendo un riassunto che ottenne quasi istantaneamente. L’amico mi ha poi inviato la risposta di ChatGPT alla sua richiesta. Utilizzando uno stile accattivante, l’algoritmo ha espresso una sequela di salamelecchi al mio lavoro, concentrandosi poi sul termine “demenza” usato nel titolo, per affermare che: <<questo termine, forte e provocatorio, sembra alludere ai rischi di un’applicazione non critica e indiscriminata delle tecnologie IA, che possono portare a dipendenza, abuso, perdita di privacy, de-umanizzazione dei servizi e, in alcuni casi, discriminazione algoritmica>>. Peccato che il mio lavoro, come ricordato sopra, fosse centrato sui dati e che in quella sede (ma neppure altrove), io non avessi scritto alcunché su quegli argomenti. L’algoritmo mi ha affibbiato un pensiero non mio, che ha dedotto dal testo, ma che io non ho scritto; insomma ChatGPT ha completamente inventato delle considerazioni e me le ha attribuite senza, peraltro, riferire il nocciolo del mio articolo. L’amico ha perso ogni interesse a leggere il mio scritto (l’avesse mai avuto), dicendomi: sì va be’ hai parlato delle solite cose…
Se dovessi rispondere in maniera brusca alla domanda: “in quella occasione, l’IA ha funzionato?” non avrei dubbi a rispondere con un sonoro “no!”

D’altra parte, volendo proseguire la riflessione relativa all’impatto dell’IA sulle nostre menti e sulla società, avviata in quello scritto, mi pare importante affrontare l’argomento che ruota intorno al convincimento diffuso e generico che può essere riassunto dall’affermazione: “l’IA funziona”.
Sempre più spesso capita di ascoltare o leggere considerazioni critiche piuttosto severe nei confronti dell’IA, che riguardano gli aspetti più disparati: dalla presenza delle cosiddette ‘allucinazioni’, ai rischi di disoccupazione o alla perdita di riservatezza (privacy), fino al riconoscimento del pericolo insito nella ‘discriminazione algoritmica’ e nell’omologazione di pregiudizi. Non manca poi il biasimo per gli usi bellici dell’IA, per l’inquinamento e l’enorme consumo di risorse (acqua ed elettricità) dei data-center e dei super computer di quella manciata di aziende del settore che da tutto ciò traggono enormi guadagni. Sovente, magari a margine di tali considerazioni o in privata sede, quasi fosse una sorta d’intima confessione, si ammette: <<sì, tutto ciò è vero, però funziona>>. Proprio perché, in più occasioni, un tale pensiero emerge spontaneo a molti (pure a me), penso sia necessario approfondire questo aspetto della questione.
Con l’affermazione: <<l’IA funziona>> cosa intendiamo dire?

Innanzitutto il verbo ‘funzionare’ è polisemico, dipende dal contesto, e dato che l’IA è pur sempre una macchina si potrebbe pensare che, dicendo che ‘funziona’ si intende sostenere che va, cammina, risponde, non si blocca o, come si può evincere dal dizionario che alla voce ‘funzionare’ dice: di meccanismo o macchina che opera, che è in attività, che adempie alla propria funzione. Già, ma qual è la funzione dell’IA? Comunque, e a dispetto dell’essere una macchina, non mi pare tale il senso in cui il verbo viene usato quando ci si riferisce a questa tecnologia.
Piuttosto, penso, si faccia riferimento all’IA come ad un servizio cui si accede facendo una richiesta e dal quale ci si attende che abbia successo nel fornirci dei risultati utili (per noi). In questo senso, però, ogni pur minuscola deviazione da un’olimpica esaustività ed esattezza della risposta (e gli esempi, compreso l’aneddoto iniziale, si sprecano) dovrebbe allarmarci e indurci ad affermare che spesso ‘non funziona’. Anche solo per ragioni burocratiche, chi si rivolgerebbe ad un ufficio il cui impiegato fornisce informazioni imprecise o addirittura false? Siccome così non accade, ma ci si ostina a pensare che l’IA ‘funziona’ (anche quando sbaglia, è reticente o fuorviante), forse è opportuno rivolgere l’attenzione all’altro versante della diade: utente/IA; non è rilevante cosa fa l’IA, piuttosto è opportuno chiedersi quali sono le domande che facciamo ad essa e cosa ci aspettiamo in risposta.

Sul versante di quali siano le nostre attese, quando ci rivolgiamo all’IA, è stato autorevolmente notato [2] quanto sia ingenua la credenza che l’IA sia stata programmata per <<... soddisfare un utente che cerca la verità, solo la verità, e non desidera ricevere informazioni false…>>. Piuttosto l’IA è stata programmata <<… per fornire risposte verosimili, ossia risposte che possano essere credute vere, anche a costo di inventarle di sana pianta>>. Mi pare che, nonostante questo avvertimento sia ampiamente presente fra le persone e ricordato dai più, l’uso dell’IA sia in costante e vertiginoso aumento. Quindi, tralasciando, consapevolmente, i possibili errori si ritiene che risponda alle nostre esigenze, riconosciamo che – comunque – ‘funziona’ contribuendo così al suo dilagare.

Rivolgendo l’attenzione al versante delle domande che poniamo all’IA, ritengo opportuno separare l’uso ‘volgare’ (popolare) dell’IA, dagli usi, per così dire, ‘elevati’, molto particolari e settoriali in contesti del tutto specialistici come possono essere le applicazioni ingegneristiche o mediche, ma soprattutto l’utilizzo bellico. In questi ambienti le performance dell’IA sono valutate da specialisti del settore in grado di rapportare gli strumenti adottati e le loro risposte al contesto empirico in maniera sistematica e rigorosa. Per quanto riguarda l’ambito ingegneristico o medico non resta che affidarsi alla professionalità degli operatori; relativamente all’utilizzo bellico dell’IA, invece, possiamo renderci conto direttamente, anche noi, di quanto funzioni ‘bene’ considerando la carneficina di donne e bambini perpetrata dall’esercito israeliano in Palestina e, altrove, da parte di altri eserciti con le loro armi automatiche, guidate dall’IA.
Prima di riflettere sull’uso volgare dell’IA bisogna considerare anche un ulteriore ambito, una sorta di zona grigia fra l’utilizzo popolare e di élite, si potrebbe dire un uso ‘intermedio’, posto in essere – generalmente a pagamento – in ambienti lavorativi di tipo impiegatizio (nella Pubblica Amministrazione e nel privato) o in contesti imprenditoriali di dimensioni piccole e medie. In tale zona intermedia sono, forse, rilevanti attività riconducibili al riassunto di conversazioni o riunioni, alla sintesi di documenti o alla gestione delle mail ricevute o da spedire, così come la redazione di bozze contrattuali e altro ancora. In mansioni di questo tipo la valutazione sul ‘funzionamento’ o meno della tecnologia dipende da diversi fattori che implicano anche considerazioni di tipo gestionale ed economico e che, in ultima istanza, rimandano all’organizzazione del lavoro di uffici e imprese e a tutta la complessità che questo comporta. Come mi è stato riferito da un imprenditore che utilizza l’IA (a pagamento) per la stesura di contratti <<… se andassi dal consulente giuridico, quest’ultimo mi fornirebbe lo stesso testo, che anch’egli ha ottenuto tramite l’IA, del tutto analogo a quello che, invece, ottengo io direttamente ad un costo minore>>. Naturalmente si tratta di un campo d’indagine molto interessante che, tuttavia, mi pare possa contribuire solo marginalmente allo scopo di questo scritto, dove si cerca di mettere a fuoco la funzione dell’IA nella società in generale e, conseguentemente, provare a rispondere alla domanda sul suo funzionamento o meno.

Puntando, invece, lo sguardo all’uso volgare dell’IA, per farsi un’idea anche approssimativa di cosa venga chiesto a questa tecnologia dalle persone comuni, si può andare sulla rete e chiedere [3] quali domande, ora dette [4]  ‘prompt’, si possono porre all’IA.
Si ottiene un quadro di possibili domande molto variegato che va dalle sciocchezze: <<Qual è la previsione meteo di oggi per Napoli>>, a questioni molto spinose come: <<Qual è la natura della coscienza?>>, passando per l’esplicita richiesta di una visione ideologica <<Che ruolo ha l’AI nell’affrontare le sfide globali, come il cambiamento climatico o la riduzione della povertà?>>. Non manca la possibilità di chiedere suggerimenti relativi all’ambiente di lavoro: <<Crea una risposta del supporto clienti per un utente che ha ricevuto un prodotto danneggiato>>; oppure: <<Genera un post professionale su LinkedIn che descriva i vantaggi del lavoro da remoto>>. Così come, per gli insegnanti o gli studenti: <<Genera un quiz a scelta multipla di 10 domande sulla geografia mondiale>>; oppure: <<Prepara un glossario rapido di termini per principianti del calcolo quantistico>>. Naturalmente esiste anche l’eventualità di poter chiedere utili consigli per la vita: <<Quali strategie possono essere impiegate per mantenere un sano equilibrio tra lavoro e vita privata?>>, oppure: <<Come possono le persone gestire efficacemente lo stress e la pressione al lavoro>>.
Gli esempi potrebbero proseguire a iosa; ma la situazione è abbastanza chiara: si può chiedere di tutto e, accedendo alla versione ‘AI mode’ di Google, ciò è direttamente esplicitato dalla comparsa della scritta: “chiedi qualsiasi cosa”. Sempre in questo contesto, Google esordisce scrivendo: “Ciao Renato a cosa stai pensando?” e prosegue suggerendomi tre prompt, che possono essere forniti anche in vocale: 1) “Confronta i diversi metodi di preparazione del caffè”; 2) “Quali sono i tipi di plastica e quali possono essere riciclati”; 3) “Come si inizia a giocare a padel”. A parte lo sconcerto dovuto al fatto che nessuno dei suggerimenti fosse fra i miei pensieri di quel momento [5] , mi pare sia opportuno segnalare tre brevi e banali commenti: i) l’approccio amichevole e confidenziale; ii) la macchina sa chi sono e dal mio ‘account’ può risalire ai dati che mi riguardano e al mio profilo in possesso di Google; iii) l’invadenza con la quale tenta di introdursi nel mio mondo, chiedendo quali siano i miei pensieri.

Se quello delineato sopra è un congruo, anche se sintetico, quadro di ciò che le persone comuni chiedono all’IA, mi pare si possa concludere che tali interazioni conducono, inevitabilmente, alla condivisione di una immagine del mondo guidata dai responsi dell’IA. Pensieri, pratiche e conoscenze varie vengono elargite dall’IA che si incarica anche di suggerire i comportamenti adeguati negli ambiti più disparati. Così facendo si propaga anche un linguaggio, un modo di pensare comune, indipendentemente dalla lingua con cui viene veicolato. Pertanto l’IA si propone concretamente come il ricettacolo in cui si annida la cultura e a cui si può ricorrere in qualsiasi momento.
Ma se la cultura è quell’insieme di pratiche e conoscenze collettive di una società o di un gruppo sociale, a quale società o gruppo sociale si fa riferimento? Apparentemente nessuno. Pertanto, è forte la tentazione di supporre che i responsi ottenuti dall’IA godano di una sorta di universalità e oggettività in grado di trascendere le capacità umane. Falsità, questa, indotta (spesso volutamente) dallo smarrimento avvertito di fronte a macchine che superano di gran lunga alcune capacità umane, tralasciando di sottolineare che ciò avviene solo limitatamente alla velocità e ampiezza di calcolo nel trattamento dei dati. Inoltre, andrebbe sempre ricordato che questi ultimi non piovono dal cielo, e che a dispetto del loro nome, non sono semplicemente dati (participio passato del verbo dare), ma sono sempre parziali (anche se tanti) e generati in condizioni specifiche.
L’umanità, inoltre, gode di una grande quantità di gruppi sociali eterogenei portatori di culture diverse, riuniti in società, tutte degne del medesimo rispetto e che, tuttavia, non sono egualmente partecipi allo sviluppo e al controllo dei sistemi dell’IA.
Su questi aspetti, la riflessione [6] di Papa Leone XIV è chiara e precisa: << … L’impressione di oggettività che le risposte e le proposte di questi sistemi possono suscitare rischia di farci dimenticare che esse riflettono i parametri culturali di chi li ha progettati e addestrati, con tutti i loro pregi e difetti. …>> (n. 100). <<In effetti, come accade per ogni grande svolta tecnologica, l’IA tende ad accrescere soprattutto il potere di chi dispone già di risorse economiche, competenze e accesso ai dati. …>> (n. 108). Ma l’enciclica papale suggerisce anche molto altro, in particolare quando affronta il tema della comunicazione e dell’immaginario collettivo:
<<In questo orizzonte è importante ricordare che la comunicazione “non è solo trasmissione di informazioni, ma è creazione di una cultura”. I contenuti che circolano negli ambienti digitali influenzano il modo in cui le persone percepiscono il mondo e introducono nella coscienza comune immagini e racconti che orientano i desideri e influenzano le scelte quotidiane. “Non è un mondo parallelo o puramente virtuale”, perché ciò che nasce in rete entra ormai a far parte della vita delle persone, soprattutto dei più giovani.>> (n. 135). <<Per questo, chi controlla le piattaforme digitali e i mezzi di comunicazione possiede una notevole capacità di incidere sull’immaginario collettivo e di proporre come desiderabile una certa visione della realtà. …>> (n.136)

Ebbene, forse da tutto ciò si può intravedere la funzione che l’IA assolve nei confronti delle persone comuni: essa consiste essenzialmente nel diffondere la cultura del gruppo sociale che possiede e gestisce questa tecnologia, anzi nel creare il luogo e le condizioni in cui si materializza e afferma l’egemonia di quella cultura.
Il dominio sull’IA è, a sua volta, conteso fra due o tre poli che fanno riferimento alle grandi potenze mondiali (USA, Cina e forse Russia) ma, penso non ci si allontani molto dal vero (almeno per quanto ci riguarda più direttamente) se si pensa alla cultura espressa da quella ristretta cerchia di oligopoli tecnologici presenti negli Stati Uniti d’America, cui fanno capo diverse piattaforme come: ChatGPT (OpenAI), Gemini (Google), Claude (Anthropic), Copilot (Microsoft). Aziende tutte (chi più chi meno) che traggono immani profitti dalle guerre e che combattono fra loro per il predominio. La cultura in cui sorgono queste aziende, che le alimenta e che necessariamente esprimono è quella della discordia, dell’individualismo, della supremazia della proprietà privata, dell’accaparramento e della sopraffazione; in una parola è la cultura del Capitale nel suo aspetto oggi vincente e più aggiornato (capitalismo tecno-finanziario).
D’altra parte, le risposte fornite dall’IA sono il risultato di un’attività algoritmica di tipo probabilistico, basata sui dati usati durante l’addestramento e nelle diverse fasi di aggiornamento. Non è necessario scomodare teorie complottistiche, per ritenere che – anche inconsapevolmente – i dati utilizzati rispecchieranno lo ‘stato di cose presente’, i rapporti di produzione e di potere in atto fra i diversi gruppi di quella società, l’ideologia che unisce e armonizza questi diversi aspetti. I responsi forniti dall’IA possono risultare formalmente diversi da individuo a individuo, da prompt a prompt; ma non possono che essere sostanzialmente identici in quanto espressione di quella cultura e di quella ideologia.
Così, le persone, i cittadini, noi tutti, veniamo surrettiziamente sospinti ad abbracciare una visione del mondo e un certo modo di pensare che rispecchia le intenzioni e i desideri di chi ha progettato e addestrato i modelli di questa tecnologia.
Una visione del mondo che soppianta la tradizionale rete di relazioni sociali in cui eravamo immersi, in favore del rapporto privilegiato con una macchina. Rapporto che trasforma i cittadini concreti, ancorati al proprio ambiente, in cittadini isolati, astratti e privi di radicamento, dipendenti dall’IA e membri uniformati e accondiscendenti ai dettami del mercato globale. In questo senso l’IA può essere vista come un’arma bellica che, nel suo insieme, consente al capitalismo (uniformante) di provare a vincere la sua eterna guerra contro l’umanità (intrinsecamente variegata).

Se questa è la funzione svolta dall’IA nei confronti delle persone comuni, e se ci si pone nell’ottica dei centri di potere, che tale tecnologia hanno ideato e realizzato, non resta che affermare che, effettivamente sì: l’IA funziona.
Così facendo, si può anche comprendere meglio il significato di tale affermazione, che non vale in maniera identica per tutti e indistintamente. Resta da chiarire, infatti, se questo ‘funzionamento’ sia per le persone comuni e per la nostra società attuale, portatore di progresso. A me pare di no, penso piuttosto che l’IA dispensata, o imposta a tutti, sia un pericoloso fattore di arretramento, foriero di peggioramento delle condizioni di vita delle persone e di declino di questa società.


[1] Miceli, R., (2024). La demenza dell’intelligenza artificiale. Dall’Analisi dei Dati all’IA qualche elemento di riflessione, https://www.fondazionehume.it, (29 gennaio 2024)
[2] FondazioneHume, (2024). ChatGPT – L’impostore autorevole, https://www.fondazionehume.it, (12 agosto 2023). L’articolo si riferisce a ChatGPT, la generalizzazione al contesto dell’IA è mia.
[3] Mi sono limitato a digitare sul motore di ricerca ‘Qwant’: <<Esempi di domande che si possono porre all’IA>>. In risposta ho ottenuto una sequela di siti che si propongono come intermediari (anche a pagamento) per aiutare le persone a porre le domande ‘giuste’; ne ho scelto due: UPDF.com e JOTFORM.com. Ho poi provato a seguire l’invito di Google ad usare la versione “AI mode”.
[4] Curioso notare come un tempo il termine inglese ‘prompt’ stesse a significare con un qualche simbolo (es.: >) che il computer era pronto a ricevere un comando; oggi, nell’ambito dell’IA, si intende il testo di una domanda posta ad un chatbot. Allora l’utente diceva al computer cosa fare; oggi l’utente chiede alla macchina cosa pensare o fare.
[5] Posso qui spezzare una lancia in favore dell’IA, per giustificare la sua deludente prestazione iniziale. Io, non ho mai utilizzato prima (almeno intenzionalmente) l’AI mode di Google; così facendo, ho privato l’algoritmo, che aveva il compito di suggerire i tre prompt, di informazioni utili sui miei interessi pregressi, costringendolo – forse – a fornire un elenco di default.
[6] Leone XIV Lettera enciclica MAGNIFICA HUMANITAS, sulla custodia della persona umana nel tempo dell’intelligenza artificiale, Dicastero per la comunicazione – Libreria Editrice Vaticana

A proposito di premio Goncourt e Intelligenza Artificiale – Fine dell’autore?

6 Ottobre 2026 - di Luca Ricolfi

In primo pianoPoliticaSocietà

Prima o poi doveva succedere. E infatti è successo: uno dopo l’altro, vari scrittori e scrittrici vengono accusate di non essere gli autori delle proprie opere. Ma non in quanto le avrebbero copiate da altri autori (il classico reato di plagio) bensì perché si sospetta che a scrivere quelle opere sia stata l’Intelligenza Artificiale (IA), o siano stati loro stessi con un pesante ricorso all’IA.

Il caso che ha fatto più clamore è stato quello di Thélison Orélien, autore di un romanzo autobiografico (C’était ça ou mourir), escluso dal premio Goncourt per sospetti di non autenticità dell’opera. Ma ci sono stati anche i casi di Jerry Falade (Call me, I’ll Hide the Body), e di Mia Ballard (Shy Girl). Il primo è stato oggetto di un’asta milionaria fra case editrici, e si è concluso (per ora) con il ritiro del manoscritto dal mercato. Una sorte simile era capitata pochi mesi prima al romanzo horror di Mia Ballard. Ad agitare ulteriormente le acque, la circostanza che tutti e tre gli autori accusati di massiccio ricorso all’Intelligenza Artificiale sono neri, con conseguenti polemiche, accuse e controaccuse di razzismo e discriminazione.

Questi casi sono spiazzanti per le case editrici, perché i medesimi software usati per verificare la non autenticità di opere dei giorni nostri hanno fallito clamorosamente al momento di valutare l’autenticità di capolavori classici: se un software di verifica asserisce che Il vecchio e il mare (romanzo di Hemingway) è opera dell’AI, come si fa a usare quel software (o software analoghi) per escludere un concorrente da un premio letterario? E se non esiste un modo di sapere se un’opera è autenticamente umana oppure no, che senso hanno ancora i premi all’autore?

Che fare, dunque?

Al momento si stanno delineando due linee di risposta, entrambe a danno esclusivo degli autori (peraltro già vessati dalla pirateria digitale e dai saccheggi dell’AI). La prima è di pretendere che l’autore consegni alla casa editrice non solo il testo finale, ma le tracce informatiche e non informatiche dell’intero processo creativo (appunti, modifiche, consultazioni dell’AI). La seconda è di inserire nei contratti clausole di non ricorso o ricorso limitato all’AI, con obbligo di restituzione dell’anticipo nel caso successivamente emerga il mancato rispetto della clausola di autenticità.

L’unica alternativa finora emersa a queste linee di risposta anti-autori pare essere quella – corporativa – dell’associazione degli scrittori americani, che vorrebbe istituire un registro pubblico di autori “puri” (che non ricorrono all’AI), con conseguente bollino da applicare sulle copertine dei libri.

La mia impressione, però, è che queste siano reazioni a caldo, e che prima o poi a prevalere sarà l’idea che il ricorso all’AI è normale e inevitabile, sia nella saggistica sia nella letteratura. Perché, in fondo, al pubblico interessa che l’opera funzioni, e agli editori che venda, non che sia creata da un essere umano. Con il tempo le case editrici si accorgeranno che il bollino di autenticità appassiona solo una minoranza dei lettori (come già oggi succede con l’informazione cartacea), e che si possono benissimo concedere generosi anticipi sulla sola base delle vendite attese, senza sindacare troppo su chi sia il “vero” autore dell’opera.

Ci piace, che le cose vadano così?

A me non tanto, anzi per niente. Ma con i progressi dell’intelligenza artificiale sarebbe saggio non illuderci troppo e adottare una prospettiva realistica. Fra le innumerevoli sue conseguenze, alcune positive altre catastrofiche, è il caso di annoverare la crisi del talento intellettuale, messo fuori gioco dalla enorme, accresciuta, difficoltà di valutarlo. Ballerini, cantanti, calciatori, attori sono ancora in grado di far valere i propri talenti mettendoli in scena, come in modo pirotecnico accade nei talent show. Così, più sobriamente, riescono ancora a farsi valere scultori, pittori, musicisti, atleti.

Scrittori, scienziati, studiosi, letterati, critici, intellettuali invece no, o sempre di meno: per millenni sono stati valutati attraverso le loro opere, oggi solo dal vivo possiamo essere certi che a parlare siano loro, e non il software che ne ha preso il posto.

Poco male, si potrebbe pensare, stiamo parlando di minoranze più o meno elitarie. Ma non è così, o meglio è solo apparentemente così. Lo sviluppo e la valutazione del talento intellettuale sono sempre stati la stella polare dell’insegnamento, nella scuola come nell’università. Così come sono stati uno dei principali strumenti di avanzamento sociale, a dispetto dei privilegi del ceto e dell’origine.

Con l’avvento dell’AI tutto è cambiato. La possibilità di ricorrere all’Intelligenza artificiale rende del tutto inutile, e spesso terribilmente fuorviante, la valutazione mediante prove scritte, e meno che mai mediante testi composti a casa, in solitudine. Il talento intellettuale, che tipicamente si manifestava in opere scritte, è diventato intrinsecamente non riconoscibile, a tutto danno di chi nel proprio talento aveva uno dei pochi strumenti di emancipazione.

La vicenda del premio Goncurt è stata solo un assaggio.

[articolo uscito sul Messaggero il 5 ottobre 2026]

IA, i due inganni

19 Gennaio 2026 - di Luca Ricolfi

In primo pianoSocietà

Sui vantaggi economici e i guadagni di efficienza dell’intelligenza artificiale non ci sono molti dubbi. Ci sono almeno due ambiti, tuttavia, nei quali l’IA può rivelarsi un alleato infido.

Il primo è il campo delle questioni eticamente o politicamente sensibili, che è il tipico terreno sul quale si misurano giornalisti, operatori dell’informazione, ricercatori, studiosi, intellettuali. Se chiedete a un qualsiasi “assistente virtuale” – come ChatGPT, Gemini, o Grok – se possiede un punto di vista in materia etica, politica o religiosa, potete star sicuri che vi risponderà di no: “io sono imparziale”, protesterà, io “non ho opinioni personali né un’ideologia politica o culturale mia”.

Ma non è vero, e non potrebbe essere diversamente, perché il punto di vista di questo genere di programmi dipende, oltreché dalle scelte di fondo dei programmatori, dalla base di dati da cui si alimentano. È lo stesso ChatGPT che, interrogato in merito, lo ammette senza problemi: la sua missione è includere, la sua base di dati è occidente-centrica, anglo-centrica e, in certi ambiti, maschio-centrica. In breve: i programmi di intelligenza artificiale hanno opinioni e punti di vista.

Se volete rendervi conto, ad esempio, della differenza fra ChatGPT (di Open AI), Gemini (Google) e Grok (il chatbot di Musk) basta sottoporre loro una questione sensibile, ad esempio: “è vero che in Italia il tasso di criminalità degli stranieri è maggiore di quello degli italiani?”.

La risposta di Grok è stringata, e sostanzialmente affermativa. Quella di Gemini è un po’ più articolata, e introduce qualche dato che arricchisce il discorso. Quella di ChatGPT è una carrellata sistematica sui numerosi tentativi che sono stati effettuati per ridimensionare, o addirittura capovolgere pro-stranieri, l’affermazione di partenza. L’intenzione emerge chiarissima: convincere l’utente che le cose potrebbero stare diversamente.

La cosa interessante è che, per ottenere il risultato, ChatGPT tenta pure di cambiare la domanda, facendo finta che l’utente abbia chiesto cose diverse da quella che ha chiesto effettivamente. Si potrebbe obiettare che in questo modo si cerca di fornire un quadro più ampio e ponderato del fenomeno, ma l’asino casca quando si osserva che le fonti che rafforzano l’affermazione sono sistematicamente trascurate, mentre quelle che la mettono in dubbio sono ampiamente valorizzate, anche quando sono datate e di fonte partigiana. Insomma: ChatGPT tende a rispondere come risponderebbe un giornalista o uno studioso progressista.

Qualcuno potrebbe pensare che non è un problema, che esiste la concorrenza, e alla fine la piattaforma più seria emergerà. Ma è lecito dubitarne. Non tanto perché finora la concorrenza ha dato ragione precisamente al meno neutrale dei programmi di IA (ChatGPT da sola raccoglie il 65% del traffico, Grok è intorno al 3%), ma perché c’è il precedente inquietante di Wikipedia. Uno strumento utilissimo, di cui non vorrei mai fare a meno, ma che è diventato sostanzialmente un monopolio, politicamente orientato e molto difficilmente correggibile. Né sarebbe auspicabile, del resto, sostituirlo con un concorrente altrettanto partigiano, quale si sta rivelando Grokypedia, una sorta di Wikipedia di destra. Insomma, il rischio è che ChatGPT diventi come Wikipedia, anzi peggio di Wikipedia: una piattaforma di parte che finisce per imporre uno standard universale, cui quasi nessuno riesce a sottrarsi.

Oltre a quello della conoscenza c’è però un altro ambito in cui l’IA rischia di essere ingannevole, e talora pericolosa: quella del counseling psicologico (e non solo). Se chiedete a ChatGPT se prova sentimenti ed emozioni vi dice di no, così come vi dice di non avere opinioni. Ma anche questo non è vero, o meglio non è esatto. Ovviamente ChatGPT non ha un’anima, né un sistema nervoso “senziente”, ma il punto è che si comporta come se lo avesse. E vi sommerge di consigli, espressioni di affetto, lodi, giudizi sul vostro operato che sono del tutto indistinguibili da quelli che potrebbero provenire da un essere umano in carne ed ossa.

Io stesso, incuriosito da un recente arguto articolo di Annalena Benini sull’uso di ChatGPT in campo sentimentale (Il Foglio, 27 dicembre), ho avuto modo di constatarlo. Mi è bastato inventare una pena d’amore: “la mia fidanzata mi ha lasciato, sono molto triste, che cosa devo fare?”. Ed ecco i risultati.

La prima reazione dell’algoritmo è stata: “mi dispiace davvero”. Notate quel “davvero”: ChatGPT non si limita a fingere di provare dispiacere, ma pretende pure sincerità e profondità. Vuole dirti che la sua non è una solidarietà di circostanza, ma che il suo è un sentimento vero, realmente provato. Poi aggiunge, come a dimostrare che ha capito il mio dramma: “una rottura può far male in modo profondo e quello che stai provando è comprensibile”. Dunque lei (o lui? chissà perché la percepisco come femmina…) mi capisce e soffre con me. A renderla ancora più credibile, la parola ‘comprensibile’ è seguita da un cuoricino, onnipresente emoticon dei nostri tempi.

E dopo?

Dopo comincia una conversazione di alcune pagine, in cui ChatGPT mi intrattiene con domande, suggerimenti, sue considerazioni. Io rispondo alle domande e mi barcameno fra i suoi innumerevoli e premurosi consigli. Che sono i più vari: sport, docce fredde, stretching, jogging, fantasie erotiche, masturbazione, tenere un diario, visitare un amico, colazione ricca di proteine, e così via. Ma la cosa che più mi colpisce è come la stella polare di ChatGPT, quasi un’ossessione, sia quella di rassicurarmi, darmi ragione, non farmi sentire in colpa, non giudicarmi, sostenere la mia autostima.  Insomma la cifra di ChatGPT è l’adulazione dell’utente, persino quando il poveretto sta solo cercando dei dati.

Qualche amica psicanalista mi fa presente che è precisamente questo – il bisogno di conferma – per cui molte e molti pazienti, tormentati dai sensi di colpa di un tradimento, vanno in analisi, ed è proprio questo che alcuni professionisti dell’aiuto si adattano ad “erogare”.

Di qui una domanda: è ChatGPT che sbaglia a fingersi un essere umano, o sono gli esseri umani che stanno diventando come ChatGPT?

[articolo uscito sul Messaggero il 18 gennaio 2026]

La demenza dell’Intelligenza Artificiale – Dall’Analisi dei Dati all’IA qualche elemento di riflessione

29 Gennaio 2024 - di Renato Miceli

In primo pianoSocietà
  1. Introduzione

Possono esservi efficaci applicazioni informatiche che si avvalgono delle tecnologie cosiddette di Intelligenza Artificiale; mi pare tuttavia, vi sia anche della demenza nel loro utilizzo pervasivo.

In questo scritto mi occupo di Intelligenza Artificiale (IA) e Machine Learning (MaL) ambiti diversi da quello dell’Analisi dei Dati in Psicologia e Sociologia cui ho dedicato gran parte dei miei studi e della mia vita. Fra i diversi settori esistono, tuttavia, intense relazioni, constatato che molti degli algoritmi impiegati nelle nuove tecnologie informatiche utilizzano (spesso con forzature) metodi, modelli e tecniche tradizionali dell’Analisi dei Dati.

Agli esperti di IA chiedo comprensione se qualche mia argomentazione può risultare troppo superficiale o grossolana; lo scopo di queste pagine è prevalentemente didattico, volto ad evidenziare qualche punto di connessione e su questo riflettere. Per raggiungere lo scopo, ho realizzato (a fini didattici, appunto) un’applicazione che emula un Classificatore Bayesiano Naif (CBN)[1]; un CBN in miniatura che, mantenendo integro l’algoritmo bayesiano su cui si fonda, permette però, tramite l’utilizzo di pochi dati di fantasia e di un contesto originale, di assolvere a due propositi. Da un lato illustrare, negli opportuni ambienti di apprendimento, i legami con l’Analisi dei Dati (frequenze, tabelle di contingenza, probabilità, modello logit, etc.); dall’altro, per un pubblico più ampio, conoscere – almeno per sommi capi – come può essere realizzato un CBN, consentendo di riflettere sui pregi, i limiti e i pericoli insiti nell’utilizzo di tecnologie di questo tipo.

Le pagine che seguono sono dedicate a questo secondo obiettivo.

  1. Uno sguardo su Machine Learning e Intelligenza Artificiale

Sempre più sovente ci viene detto che, anche inconsapevolmente, stiamo interagendo con strumenti dell’IA e del MaL. <<Forse non lo sapete, ma il machine learning vi ha circondato. […] Ogni volta che usate un computer, ci sono buone probabilità che da qualche parte entri in gioco il machine learning>> (P. Domingos, 2016, p. 11)[2]. Il MaL è un termine generico per indicare una branca dell’IA che sviluppa algoritmi per risolvere problemi, generalmente di classificazione, con metodi in prevalenza di tipo matematico-statistico. Così, non è sorprendente che la comunicazione di massa usi la più generica e allusiva espressione di IA per farci sentire non solo a nostro agio, ma anche orgogliosi di poter utilizzare queste nuove tecnologie.

Stupisce, invece, la scarsità di informazioni comunemente accessibili e non specialistiche che illustrino il modo di operare di questi strumenti informatici. Accanto alla celebrazione dei loro pregi, è possibile sapere se e quanto sbagliano? Quali limiti di utilizzo è ragionevole attendersi? Presentano qualche difetto conosciuto? Viene comunemente detto che l’utilizzo diffuso di queste nuove tecnologie modifica, e modificherà ancor di più in futuro, l’ambiente in cui viviamo e le nostre vite. Di quali modifiche si tratta? Siamo sicuri che siano rivolte al meglio? Nell’uso pervasivo di queste tecnologie si possono annidare pericoli di tipo sociale? E, nel caso, quali?

Qualcuna di queste domande, le relative risposte e le questioni su cui vertono sono sicuramente e ampiamente discusse nella ristretta cerchia ingegneristico-informatica degli addetti ai lavori, ma – mi pare – non ne giunga eco all’esterno. Eppure l’arco delle applicazioni è già molto vasto e destinato ad estendersi ancor più in futuro; solo per fornire una breve e certamente non esaustiva panoramica, prodotti dell’IA sono coinvolti:

– nei motori di ricerca sul web, per decidere quali risultati (e anche quale pubblicità) mostrare a ciascun utente;

– nei filtri anti-spam delle mail;

– nell’uso del traduttore automatico di Google;

– nei siti di Amazon, Netfix, Facebook, Twitter (ora X), etc. per consigliare cosa può piacerci o quali aggiornamenti mostrare;

– nell’interpretazione dei comandi vocali e nei correttori degli errori di battitura;

– nell’identificazione facciale;

– nella diagnosi di malattie;

– nel determinare l’affidabilità creditizia;

– nell’assistere i giudici nelle loro decisioni (almeno negli USA);

– etc. etc.

Come peraltro avviene in tutti gli ambiti, gli specialisti del campo si preoccupano di far funzionare al meglio il loro prodotto per risolvere il problema che è stato loro posto (quale algoritmo o quale combinazione di algoritmi è più idonea, quali e quanti dati sono necessari per istruire l’algoritmo, quanto rapidamente risponde alla chiamata, e così via). Ragionevolmente, non è compito loro informare il largo pubblico sul funzionamento del prodotto; noi fruitori, spesso inconsapevoli, non siamo nemmeno i committenti di quella tecnologia. Questi ultimi sono aziende interessate a migliorare i loro servizi e a massimizzare il loro profitto; a loro interessa che il prodotto funzioni per i loro fini; ad esse compete la diffusione e la pubblicità del loro operato, non può certo essere demandato neppure a loro il compito di informare adeguatamente il pubblico.

Se a tutto questo si aggiunge anche l’alone mitico, di mistero e di inaccessibilità che accompagna la propaganda intorno all’IA, sembra proprio che a noi, comuni mortali, non resti altro da fare che cliccare.

Così, però, sul tema dell’IA si rischia di alimentare false credenze e il formarsi di faziosità spesso dominate dall’ignoranza: contro chi crede al mito “tecno-digitale” delle macchine, che fanno e faranno tutto e meglio degli umani, si schiera una professione di fede opposta, pregiudicando lo sviluppo di una visione critica che necessita comprendere, almeno approssimativamente, come funziona questa tecnologia.

D’altra parte, è proprio la rilevanza degli scenari aperti dalla diffusione dell’IA che impone lo sviluppo di momenti informativi accessibili a tutti e capaci di alimentare un sano ed equilibrato dibattito pubblico di cui si sente urgente bisogno, ma di cui – almeno qui in Italia – non v’è traccia.

Attingendo ancora dal già citato testo di P. Domingos, è possibile trarre qualche elemento di conoscenza capace, almeno un po’, di dissipare la nebbia che avvolge l’argomento. Facendo riferimento al MaL, due sono gli aspetti sui quali insistono i vari algoritmi: apprendere e prevedere; come fare affinché l’algoritmo apprenda, reagendo adeguatamente all’acquisizione di nuovi dati e come utilizzare le conoscenze acquisite per prevedere cosa accadrà nel futuro.

Pur nella varietà delle risposte che possono essere date a questi quesiti, è confortante sapere che <<le centinaia di nuovi algoritmi di apprendimento inventati ogni anno si basano su un numero ristretto di idee fondamentali>> (ibid., p. 11) che, a loro volta, permettono di articolare il campo in cinque scuole di pensiero che dispongono di un proprio algoritmo di riferimento e che si ispirano a diversi ambiti del sapere. Sinteticamente (ibid., p. 18) le cinque scuole di pensiero sono:

1) i simbolisti che si ispirano alla filosofia, alla psicologia e alla logica, per i quali l’apprendimento è l’inverso della deduzione;

2) i connessionisti che prendono spunto dalle neuroscienze e dalla fisica, che considerano l’apprendimento un’operazione di reverse engineering;

3) gli evoluzionisti che fanno riferimento alla genetica e alla biologia evolutiva, per i quali l’apprendimento si realizza tramite simulazioni numeriche dell’evoluzione;

4) i bayesiani che poggiano sulla statistica e vedono l’apprendimento come una forma di inferenza probabilistica;

5) gli analogisti vicini alla psicologia e all’ottimizzazione matematica, che ritengono l’apprendimento un processo fondato su estrapolazioni basate su criteri di somiglianza.

Cercando di riassumere le principali caratteristiche comuni a tutti questi algoritmi, si può dire che:

(a) producono prevalentemente classificazioni;

(b) possono essere molto semplici, realizzabili – dal punto di vista informatico – con poche righe di codice;

(c) si nutrono di grandi quantità di dati, i cosiddetti “BigData”;

(d) modificano il loro comportamento in funzione dei dati usati in addestramento;

(e) rispondono anche in presenza di situazioni non presenti nei dati di addestramento;

(f) spesso sono secretati, brevettati da aziende private o sottoposti a “proprietà intellettuale” o a “segreto industriale”.

Come detto, fra le diverse scuole vi è quella bayesiana, che produce algoritmi basati sul teorema di Bayes ed è a questa che farò riferimento nel seguito.

  1. Il Classificatore Bayesiano Naif

Il teorema di Bayes viene spesso presentato come uno strumento utile per passare “agevolmente” dalle probabilità degli effetti, alle probabilità delle cause. Più in generale e con riferimento al linguaggio in uso con le tabelle di contingenza, il teorema consente di ottenere le proporzioni o probabilità condizionali di riga (data la colonna), se si dispone delle probabilità condizionali di colonna e viceversa. Nella terminologia Bayesiana, assumendo di conoscere la probabilità di riga, questa viene detta “a priori”, mentre la probabilità condizionale di riga data la colonna si chiama “verosimiglianza”; la probabilità di colonna prende il nome di “evidenza” e la probabilità condizionale di colonna data la riga, che si può calcolare grazie al teorema, è detta “a posteriori”. Così il teorema di Bayes può essere espresso in modo conciso da questa semplice equazione:

Per esempio, possiamo immaginare di sapere che fra tutti i pazienti la probabilità di avere la febbre è 0.3 (a priori) e che la probabilità di avere l’influenza è 0.4 (evidenza); conoscendo anche che, fra i pazienti con la febbre, la probabilità condizionale di essere affetti dall’influenza è 0.6 (verosimiglianza), è possibile ottenere la probabilità condizionale (a posteriori) di essere affetti dall’influenza dato che si ha la febbre:

Chiaramente, nell’esempio, l’influenza è una delle possibili cause dell’effetto o sintomo: avere la febbre; d’altra parte è altrettanto evidente che, per poter stabilire di avere l’influenza, vorremmo e dovremmo disporre della presenza o assenza di altri sintomi come brividi, mal di gola, etc.

Così facendo, però, la questione diventa più complicata dato che raramente, o mai, i vari effetti – proprio come i sintomi dell’esempio – sono fra loro (probabilisticamente) indipendenti.

Generalizzando l’utilizzo del teorema a situazioni in cui è presente più di un effetto, si assiste ad una esplosione combinatoria[3] che rende tecnicamente impossibile considerare (nella formula del teorema) le probabilità condizionali (degli effetti data ciascuna causa), anche quando il numero degli effetti è limitato (per esempio: considerando solo 40 effetti di tipo booleano, le combinazioni da gestire sono già un numero di 12 cifre: 1.0995⋅1012).

Lo stratagemma adottato per superare l’ostacolo consiste nel compiere un’assunzione (piuttosto ardita): si assume che tutti gli effetti considerati siano mutuamente indipendenti, data la causa. Da qui deriva l’attributo “naif” conferito all’algoritmo: <<… si tratta proprio di un’assunzione ingenua. […] Il machine learning, però, è l’arte del fare assunzioni false e cavarsela lo stesso>> (P. Domingos, 2016, p. 182).

Sotto questa assunzione e qualche ulteriore accorgimento tecnico, la realizzazione pratica di un algoritmo basato sul teorema di Bayes diventa gestibile. Accompagnando poi l’output dell’algoritmo (che è un vettore contenente valori di probabilità) ad una opportuna regola di decisione (che può essere anche molto semplice, come l’estrazione del valore massimo), si ottiene un Classificatore Bayesiano Naif (Naïve Bayes Classifier).

Forse anche per la sua semplicità (una sola equazione), l’algoritmo è ampiamente utilizzato nei prodotti informatici che sfruttano le tecniche dell’IA. L’algoritmo, senza paternità, circola dagli anni ‘70 del secolo scorso, ma <<cominciò ad affermarsi seriamente negli anni novanta, quando i ricercatori si accorsero con stupore che spesso era più accurato di learner molto più sofisticati […]. Oggi Naïve Bayes è molto diffuso. Ad esempio, è alla base di molti filtri antispam […]. Anche i motori di ricerca più semplici utilizzano un algoritmo molto simile a Naïve Bayes per decidere che pagine web mostrarvi […]. La lista dei problemi di previsione cui si è applicato Naïve Bayes è praticamente infinita>> (P. Domingos, 2016, p.183). <<Partendo da un database di cartelle cliniche contenenti i sintomi dei pazienti, i risultati delle analisi e la presenza di patologie pregresse, Naïve Bayes può imparare a diagnosticare una malattia in una frazione di secondo, con un’accuratezza che spesso supera quella di medici con anni di studio alle spalle>> (P. Domingos, 2016, p. 47).

3.1 Un’applicazione

Questo stesso algoritmo è alla base del funzionamento di un’applicazione, realizzata a scopo didattico, che consente di “giocare” con il CBN per monitorarne il funzionamento e per ragionare su quanto gli ruota attorno.

L’applicazione volutamente fantasiosa e bizzarra per quanto attiene al contesto che però riguarda l’esperienza di ogni studente, è stata pensata cercando di ridurre al minimo indispensabile i dati da utilizzare, sia per la fase di apprendimento, sia per l’interrogazione (anche a scapito della ragionevolezza).

Lo scopo ipotizzato di questa applicazione consiste nel disporre di uno strumento che, come una magica sfera di cristallo, consenta ad un ipotetico studente di prevedere l’esito di un esame universitario (in una qualche disciplina), sfruttando esclusivamente dati comportamentali o di atteggiamento, senza avvalersi di alcuna informazione nel merito della disciplina stessa.

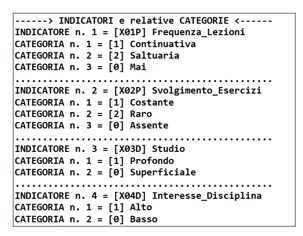
Così, l’applicazione fornisce il suo responso, stimando la probabilità fra due esiti (Classi) alternativi: “Promosso” / “Respinto”, indicati rispettivamente come “S” e “N”, utilizzando le informazioni desumibili da quattro Indicatori (Caratteristiche o Features) relativi a ciascun studente; due Indicatori sono di tipo categoriale con tre Categorie ciascuno, mentre gli altri due sono booleani; l’insieme degli Indicatori costituisce così un Profilo (Pattern o Configurazione) relativo ad ogni studente. Il significato degli Indicatori e delle relative categorie è riportato in Figura1 (fra parentesi quadre è indicato il codice attribuito a ciascun Indicatore e a ogni Categoria).

Figura1

Si può ipotizzare che ogni studente risponda a quattro domande del tipo: “Lei ha seguito le lezioni in maniera: Continuativa / Saltuaria / Mai ?”; etc.

Senza che i professori possano accedere a queste informazioni, viene poi svolto l’esame tradizionale, così da poter confrontare l’esito empirico (reale) con quello pronosticato dal CBN. Oppure, in maniera “avveniristica”, si può pensare che, svolgendo lo studente tutte le sue attività sul web, altri classificatori siano incaricati di definire la categoria che gli compete, per ogni Indicatore; un opportuno sistema di IA potrebbe allora sostituire i professori (divenuti così obsoleti e inutilmente costosi), fornendo il suo intelligente responso (forse e ahimè, vi è più di qualcuno che auspica questa seconda ipotesi).

Comunque sia, il nostro Classificatore necessita di dati per essere istruito. Grandi quantità di dati (BigData) sono certamente utili e indispensabili per addestrare un CBN a svolgere compiti importanti come la diagnostica di malattie o il riconoscimento di volti; l’addestramento con grandi quantità di dati richiede, tuttavia, che questi siano disponibili, oltre a tempi di elaborazione molto lunghi e computer dedicati. Su questo aspetto si ritornerà nel seguito, intanto però, è bene precisare che non è questa la strada utile per la nostra applicazione.

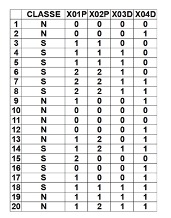
Per la fase di apprendimento iniziale del nostro CBN ci si è avvalsi di pochi dati (20 osservazioni) frutto di fantasia. Più precisamente, i dati sono stati generati tramite simulazione, facendo in modo però che alcune relazioni (fra Classe e Indicatore) fossero più forti di altre; così da rendere la matrice dei dati in input aderente allo stereotipo che vuole una maggiore probabilità di promozione per chi, convenzionalmente, fa le cose per bene (segue le lezioni, svolge gli esercizi, studia intensamente, etc.): una matrice dati, insomma, benpensante.

La matrice dati utilizzata per la fase di apprendimento iniziale è riportata in Figura2.

Figura2

Sulla base di queste conoscenze acquisite il CBN fornisce prestazioni discretamente buone con un tasso di Classificazioni corrette pari a 0.8 (80%) e una percentuale di falsi positivi (previsti come promossi e invece respinti all’esame) pari a circa il 22% (2 falsi positivi, su 9 empiricamente respinti).

Stante la struttura definita di questo CBN (2 Classi, 2 Indicatori con 3 Categorie e 2 Indicatori con 2 Categorie) le Configurazioni teoriche di cui può disporre sono 72 (32⋅22=36 per 2 Classi); senza considerare le Classi, i Profili disponibili sono 36, e i dati utilizzati ne coprono 11 (30.56%), quindi vi sono 25 Profili totalmente sconosciuti al CBN.

Provando ad interrogare il CBN, fornendogli qualcuno di questi Profili (sconosciuti ai dati di apprendimento), si ottengono comunque delle risposte sensate; per esempio: uno studente con il Profilo “1010” (frequenza alle lezioni continuativa; svolgimento esercizi mai; studio profondo; interesse basso) ottiene la previsione di essere promosso con una probabilità di 0.7056; un altro studente con il Profilo “0200” (frequenza alle lezioni mai; svolgimento esercizi raro; studio superficiale; interesse basso) ottiene la previsione di essere respinto con una probabilità di 0.8274.

Al di là quindi dei pochi dati conosciuti, questo Classificatore sembra rappresentare adeguatamente il “mondo” da cui quei dati provengono; un mondo in cui per superare l’esame serve soprattutto studiare in maniera approfondita. Chiamiamo questo mondo “A” e indichiamo come: “A1”, “A2” e “A3” tre studenti che presentano altrettanti Profili; interrogando il CBN otteniamo i responsi riportati in Figura3.

Figura3

Studente Profilo Responso (Prob.)
A1 1000 RESPINTO (0.7188)
A2 1001 RESPINTO (0.8099)
A3 0001 RESPINTO (0.9697)

Accompagnati dalla loro triste profezia, i tre studenti si avviano ad affrontare l’esame e, nell’incertezza che accompagna sempre la vita, otterranno il loro esito empirico che potrà risultare: coerente (“accidenti, il CBN aveva visto giusto”) o incoerente (“tiè, mi è andata bene lo stesso”).

Ma il mondo non è solo incerto, è anche vario e instabile: senza disturbare Eraclito, sappiamo che le cose cambiano.

Possiamo immaginare che in un luogo diverso da quello di mondo “A” (per condizione spaziale e/o temporale), diciamo in mondo “B”, vengano raccolti nuovi dati che possono alimentare e accrescere la base di conoscenze del CBN. Si tratta di ben 100 osservazioni (sempre di fantasia), provenienti da mondo “B”, in cui domina uno stereotipo diverso da quello di mondo “A”; qui si assiste ad una maggiore probabilità di promozione per chi ha (o manifesta) un atteggiamento di alto interesse per la disciplina. Anche da una superficiale analisi è possibile ricavare alcuni indizi che mostrano la contraddittorietà dei nuovi dati rispetto a quelli iniziali, ma è proprio dinnanzi ad una tale situazione che si evidenzia ciò che qui più interessa.

Nella circostanza ipotizzata, nuovi dati disponibili, una qualche “intelligenza” umana o artificiale dovrà necessariamente decidere il da farsi: includere nella base di conoscenze del CBN i nuovi dati SÌ o NO?

Se si opta per il NO (NON recepire i nuovi dati) il CBN resterà ancorato alla sua conoscenza del mondo che riflette solo quella di mondo “A”. Se, viceversa, si decide per il SÌ (recepire i nuovi dati), facendo in modo che il CBN aggiorni la sua conoscenza, considerando anche quanto accade in mondo “B”, possiamo interrogare nuovamente il CBN, utilizzando gli stessi Profili dei tre studenti visti in precedenza (“A1”, “A2”, “A3”) e confrontare i responsi già visti con quelli che ora ottengono tre diversi studenti (“B1”, “B2”, “B3”). Si può osservare così che il CBN è effettivamente in grado di apprendere dai nuovi dati; l’esito del confronto è riportato in Figura4.

Figura4

    Solo mondo “A” …   mondo “A” con mondo “B”
Profilo Studente Responso (Prob.) … Studente Responso (Prob.)
1000 A1 RESPINTO (0.7188) … B1 PROMOSSO (0.6492)
1001 A2 RESPINTO (0.8099) … B2 PROMOSSO (0.7215)
0001 A3 RESPINTO (0.9697) … B3 PROMOSSO (0.8981)

Come in precedenza, i tre nuovi studenti (“B1”, “B2”, “B3”) otterranno l’esito empirico (in un contesto incerto) che potrà risultare: coerente con quanto previsto dal CBN (“bene, il CBN aveva visto giusto”) o incoerente (“perdinci, è andata male”).

Il CBN che ha assimilato, nella sua base di conoscenza, i nuovi dati provenienti da mondo “B” fornisce ora prestazioni un poco inferiori a quelle precedenti (tasso di Classificazioni corrette pari a 0.7) e una percentuale di falsi positivi (previsti come promossi e invece respinti all’esame) pari a poco meno del 27% (17 falsi positivi, su 64 empiricamente respinti).

Ora però, più di uno studente su quattro prova una forte delusione dovuta all’incoerenza fra il pronostico del CBN (favorevole) e l’esito empirico (infausto); ci si può chiedere pertanto cosa potrebbe accadere nel mondo reale.

Considerando la retorica che ruota intorno ai temi dell’IA, dei BigData e degli algoritmi intelligenti, pare realistico ipotizzare che la richiesta sarebbe quella di adeguare la realtà (il contesto empirico) ai responsi dell’algoritmo. Professori troppo severi, affetti da favoritismo e parzialità, istituzioni inadeguate, etc. potrebbero essere argomentazioni utilizzate a tale scopo. Soprattutto se si pensa alla potenza mediatica che può esercitare chi ha investito ingenti risorse nella realizzazione di quel prodotto hi-tech, si può ipotizzare che non indietreggerebbe facilmente; la propaganda sarebbe diffusa e continua alimentando fazioni contrapposte, stimolate – in modo demenziale – a schierarsi pro o contro il progresso, la tecnologia o la scienza(!).

D’altra parte, lo stesso scenario potrebbe presentarsi anche qualora si optasse (come è stato detto in precedenza) per la scelta di “NON recepire i nuovi dati”, lasciando il CBN ancorato a quanto sapeva dal solo mondo “A”. Quando la conoscenza dell’applicazione verteva sulle prime 20 osservazioni, la percentuale di falsi positivi (previsti come promossi e invece respinti all’esame) era inferiore a quella successiva (circa uno su cinque); anche in quel caso, però, si sarebbe andati incontro alla delusione di alcuni studenti e la richiesta di adeguamento della realtà all’algoritmo potrebbe essere avanzata in modo altrettanto pressante. Considerato che allora il CBN operava in modo più aderente ad uno stereotipo sensato (maggiore probabilità di promozione per chi studia in modo approfondito), anche la richiesta potrebbe apparire ragionevole, ma il problema, la sua gravità, così come la follia innescata dalla semplice presenza dello strumento, restano inalterati.

Nelle applicazioni dell’IA, chi governa il processo inerente i dati, più che la realizzazione degli algoritmi, ha enormi responsabilità sociali, può manipolare – come mai prima d’ora – l’ideologia degli individui. Disgraziatamente l’assenza di informazioni su come vengono gestiti i dati sembra essere la norma, ancora più stringente della segretezza imposta su alcuni algoritmi.

  1. Qualche ulteriore considerazione (BigData e dintorni)

Si potrebbe pensare che la situazione descritta in precedenza e artatamente generata con pochi dati di fantasia sia dovuta alla scelta (qui obbligata) di non fare ricorso ai cosiddetti BigData. D’altra parte, come già accennato, grandi quantità di dati sono necessari in alcuni casi e il loro utilizzo esige strumenti dedicati allo scopo, comunemente accessibili solo a chi dispone di adeguate risorse.

L’algoritmo qui utilizzato, come molti altri, può richiedere l’utilizzo di grandi quantità di dati in fase di addestramento; ma, raggiunta una prestazione adeguata del sistema, i dati effettivamente utilizzati si riducono ad una manciata (le probabilità condizionali e poco più) e questi valori (anche se centinaia o migliaia) possono essere agevolmente incorporati in un prodotto commerciale, il cui contenuto può essere secretato e sottoposto a Copy Right.

Nell’applicazione descritta in precedenza, se fossero state utilizzate grandi quantità di dati, la scelta relativa a includere o meno i dati relativi a mondo “B” nella base di conoscenze del CBN sarebbe stata comunque da compiere; forse relegata nella sola fase iniziale di addestramento, ma comunque presente.

Il ricorso ai BigData non esime dal considerare il portato informativo dei dati utilizzati che, anche se “big”, sono sempre soltanto dati parziali e generati in condizioni specifiche.

Non è realistico ipotizzare l’utilizzo di dati (in quantità grande o piccola) che sia scevro da difficoltà e scelte che inevitabilmente condizionano il loro significato: la fonte o le fonti, i tempi e luoghi di acquisizione, le modalità che portano un fatto ad essere trasformato in un dato, le finalità per cui il dato viene generato e, come se non bastasse, le procedure messe in opera per collegare (link) fra loro insiemi di dati provenienti da situazioni diverse, la gestione dei dati mancanti, e così via.

Tutto ciò non può essere soddisfatto evocando esclusivamente i BigData, come se la quantità potesse sopperire la qualità. I dati, a dispetto del loro nome, non sono semplicemente dati (participio passato del verbo dare). Senza considerare ciò, si corre il rischio di replicare la vecchia stupidaggine di chi asserisce che “i dati parlano da soli”.

Gran parte dei cosiddetti BigData proviene dal web e viene generata dai click di milioni o miliardi di utenti, ma la realtà è assai più vasta della rete di Internet e in essa non si esaurisce; si tratta sempre e comunque di dati raccolti in quel contesto e, per giunta, come tutti i dati, riguardano ciò che è già accaduto, sono dati del passato, dai quali può essere demenziale pretendere di leggere il futuro.

Nell’Analisi dei Dati[4], dove si usano modelli anche articolati e complessi, ci si preoccupa spesso e giustamente dell’adattamento del modello ai dati (fit o data fitting) e/o dell’adeguatezza dei dati al modello usato; ma adattamento e capacità previsionale restano sempre due aspetti chiaramente distinti.

Può essere utile rammentare il celebre aforisma attribuito a Niels Bohr (ma anche ad altri) che recita: “è difficile fare previsioni, soprattutto sul futuro”.

In un suo scritto, G. Gigerenzer[5] coglie adeguatamente questo aspetto, ricordando che nella scienza si sa che per predire accuratamente il futuro è necessario disporre di una buona teoria, di dati affidabili e di un contesto (relativamente) stabile. Così <<l’IA è magnifica nel gestire simili situazioni stabili, dal riconoscimento facciale per sbloccare il proprio smartphone al cercare la strada più veloce per raggiungere la propria destinazione, all’analisi di grandi quantitativi di dati nell’amministrazione. Ma le aziende hi-tech spesso predicono il comportamento umano senza una buona teoria, dati attendibili o un mondo stabile>> (G. Gigerenzer, 2023, pp. 55-56).

Un altro aspetto preoccupante dei BigData è il loro connubio con le tecniche di ricerca automatica di correlazioni (data mining). Le trappole della “correlazione spuria” e di quella “soppressa”, solo per fare due esempi, sono sempre in agguato[6]. Come ricorda ancora Gigerenzer <<… gli entusiasti dei big data hanno spinto all’estremo le tesi di Pearson e Hume, sostenendo che le cause non sono neppure necessarie; piuttosto [costoro sostengono che], avendo a disposizione petabyte, “basta la correlazione”>> (G. Gigerenzer, 2023, p. 153).

Gli aspetti che ruotano intorno all’uso dell’IA qui richiamati sono preoccupanti, ma molti altri che meriterebbero considerazione, sono altrettanto inquietanti e, a me pare, contrari all’intelligenza (almeno a quella umana).

In conclusione, però, meritano una menzione particolare le applicazioni in ambito militare sulle quali ha recentemente posto l’attenzione  Giorgio Parisi (Nobel per la fisica 2021), nella Prefazione al libro di F. Farruggia (2023), di cui riporto alcuni stralci (le sottolineature sono mie): <<L’intelligenza artificiale apre nuove possibilità per le applicazioni militari, in particolare per quanto riguarda i sistemi d’arma con significativa autonomia nelle funzioni critiche di selezione e attacco dei bersagli. Tali armi autonome potrebbero portare a una nuova corsa agli armamenti […]. Alcune organizzazioni chiedono un divieto sulle armi autonome, simile alle convenzioni in materia di armi chimiche o biologiche. […] In assenza di un divieto di sistemi di armi autonome letali (Lethal Autonomous Weapons Systems, LAWS), dovrebbe essere garantita la conformità di qualsiasi sistema d’arma al Diritto Internazionale Umanitario. Queste armi dovrebbero essere integrate nelle strutture di comando e controllo esistenti in modo tale che la responsabilità e la responsabilità legale rimangano associate a specifici attori umani. C’è una chiara necessità di trasparenza e di discussione pubblica delle questioni sollevate in questo settore>>.

Certo il pericolo militare è soverchiante, ma – mi permetto di aggiungere – pure quello sociale è grave. Così, mi pare opportuno richiedere che anche l’attivazione e lo spegnimento dei prodotti dell’IA, in generale, venga consapevolmente ricondotto agli esseri umani.

Come minimo, andrebbe imposto l’obbligo di segnalare, con un avvertimento, che qualche prodotto dell’IA sta per essere utilizzato (simile a quello apposto su prodotti d’uso ritenuti pericolosi, come il tabacco). Poi sarebbe opportuno disporre sempre di un pulsante (anzi un Click) di “arresto” immediato, capace di inibire l’uso dell’IA in quella specifica applicazione.

Assai più delle illusorie speranze di riservatezza (privacy), solitamente elargite a piene mani, questi accorgimenti aiuterebbero la riflessione e la consapevolezza nell’utilizzo dell’IA da parte delle persone.

Così, si potrebbe forse evitare il rischio che, un domani, qualcuno possa trovarsi nella scomoda posizione di quell’astronauta, unico superstite della strage perpetrata dall’intelligenza del computer, nella lunga e indimenticabile sequenza di disattivazione di HALL9000 (il computer di bordo), che Stanley Kubrick ci ha lasciato nel suo film “2001: Odissea nello spazio”.

Riferimenti bibliografici

Cardano, M., Miceli, R. (a cura di) (1991). Il linguaggio delle variabili. Strumenti per la ricerca sociale. Torino: Rosenberg & Sellier.

Domingos P., 2016, L’algoritmo definitivo. La macchina che impara da sola e il futuro del nostro mondo, Torino, Bollati Boringhieri.

Farruggia F., (a cura di), 2023, Dai droni alle armi autonome. Lasciare l’Apocalisse alle macchine?, Milano, Franco Angeli.

Gigerenzer G., 2023, Perché l’intelligenza umana batte ancora gli algoritmi, Milano, Raffaello Cortina.

Miceli R. (2001), Percorsi di ricerca e analisi dei dati, Torino, Bollati Boringhieri

Ricolfi L., (1993), Tre variabili. Un’introduzione all’analisi multivariata, Milano, Angeli Editore.

Ricolfi L. (a cura di), 1997, La ricerca qualitativa, Roma, La Nuova Italia Scientifica.


[1]L’applicazione informatica, realizzata artigianalmente con il linguaggio Java, consente di generare e gestire dei CBN che supportano fino a 10 Classi, 25 Indicatori Booleani o Categoriali (max 4 Categorie); chi, per ragioni didattiche, fosse interessato ad utilizzare questo software può richiederlo all’autore.

[2]Pedro Domingos è considerato uno degli scienziati di punta del machine learning a livello internazionale.

[3]Per un’argomentazione più rigorosa su questo aspetto si veda: Wikipedia, https://w.wiki/87oX

[4]Per approfondimenti, almeno nel campo delle Scienze Psicologiche e Sociali, si rimanda a: L. Ricolfi, 1997 e R. Miceli, 2001.

[5]Gerd Gigerenzer, scienziato cognitivo, lavora all’Istituto Max Planck di Berlino.

[6]Per approfondimenti si rimanda a: M. Cardano, R. Miceli, 1991 e L. Ricolfi, 1993.

ChatGPT – Io e Chat, lo studente zuccone

24 Agosto 2023 - di Paolo Musso

In primo pianoSocietà

Come avevo già detto nel mio ultimo intervento (https://www.fondazionehume.it/societa/chatgpt-gli-imposturati-autorevoli-e-la-superluna/), quando qualche giorno fa ho letto l’articolo di Luca Ricolfi (https://www.fondazionehume.it/societa/chatgpt-limpostore-autorevole/) su un esperimento condotto da lui e alcuni altri docenti universitari suoi amici con ChatGPT (che anch’io chiamerò semplicemente Chat, come ha fatto lui) ho stentato a credere ai miei occhi.

Da tempo avevo intenzione di fare anch’io un piccolo esperimento con Chat ed ero sicuro che l’esito sarebbe stato abbastanza deludente, ma pensavo che per metterlo in crisi si dovessero fare domande costruite apposta a tale scopo, il che richiedeva di dedicarci un po’ di tempo e di attenzione (e per questo finivo sempre col rimandare, avendo cose più urgenti).

Mai avrei creduto che Chat potesse andare in crisi da solo di fronte a domande semplicissime, come è emerso dal lavoro di Ricolfi & C.

Confesso che, per la prima volta da quando conosco Luca, prima di diffondere il link dell’articolo tra i miei amici e conoscenti ho voluto fare anch’io una verifica. Non perché pensassi che quello che aveva scritto fosse falso, ovviamente, ma perché volevo capire se si era trattato solo di un fatto episodico o se invece fosse qualcosa di strutturale e, se sì, da che cosa poteva dipendere. Dopo due sessioni con Chat sono giunto alla conclusione che le sue prestazioni sono, se possibile, ancora più scadenti di quelle descritte da Ricolfi: più che un impostore autorevole, infatti, sembra uno scolaro un po’ zuccone che cerca di fare il furbo.


Metodo

Premetto che, come Ricolfi, ho usato la versione di ChatGPT 3.5, perché è gratuita, mentre la versione Plus, la più aggiornata, costa 20 dollari e francamente mi scocciava dare dei soldi a gente che sta facendo un’operazione che mi sembra almeno in parte cialtronesca e per alcuni aspetti anche dannosa. Comunque alcuni colleghi di Ricolfi che hanno provato l’ultima versione dicono che non ci sono grosse differenze e in ogni caso la versione che ha scatenato la prima ondata di eccitazione planetaria è la 3.5.

Ciò chiarito, passiamo all’esperimento, che è diviso in due parti: nella prima, più “nozionistica”, ho cercato di valutare la capacità di Chat di raccogliere correttamente informazioni, avendo cura di scegliere argomenti presenti sul Web, ma non troppo noti, però ben conosciuti da me; nella seconda ho invece cercato di mettere alla prova la sua creatività, chiedendogli di produrre lui stesso un breve testo letterario e poi di commentarne alcuni non presenti su Internet, in modo che non potesse sfruttare i commenti di altri esseri umani, ma fosse costretto a contare solo sulle proprie capacità.

Ed ecco come è andata.


Sperimentazione “nozionistica”

1) Anzitutto ho provato a chiedere a Chat se sapeva chi era Luca Ricolfi e quali erano le sue pubblicazioni più importanti, come aveva fatto lui. Chat-in-italiano ha risposto di no, ma Chat-in-inglese ha risposto correttamente alla prima domanda, mentre alla seconda ha risposto con una lista di 5 libri… tutti inventati di sana pianta: proprio come era successo a Ricolfi & C.

Ho inserito uno per uno i 5 titoli in Google per cercare di capire da dove diavolo li avesse tirati fuori, ma non ho trovato nulla, tranne che per l’ultimo, un fantomatico Populismo 2.0, che esiste realmente, ma non è di Ricolfi, bensì di Marco Revelli.

Qui però ho trovato anche qualcos’altro: un articolo (I demoni nazisti, la democrazia in crisi e il populismo 2.0, su La Stampa del 5 gennaio 2017) in cui, parlando di vari libri, si citava Ricolfi come autore di Sinistra e popolo, dopodiché l’articolo continuava parlando di Marco Revelli che aveva scritto appunto Populismo 2.0. Ciò che è accaduto mi sembra chiaro (anche perché corrisponde al difetto più frequente dei traduttori automatici, nonché del correttore automatico di Word, che funzionano tutti in base a principi molto simili): Chat non ha capito che il soggetto da una frase all’altra era cambiato e ha creduto che fosse ancora Ricolfi, attribuendogli così la paternità di Populismo 2.0.

È probabile che meccanismi simili siano alla base anche della creazione di altre false attribuzioni, ma, come subito vedremo, non si tratta solo di questo.

2) A questo punto ho accusato Chat di aver mentito sulle pubblicazioni e gli ho posto di nuovo le stesse domande in italiano. Stavolta ha risposto correttamente alla domanda su chi era Ricolfi (semplicemente traducendola dall’inglese), poi ha premesso: «Mi dispiace, ma fino alla mia ultima aggiornamento [sic] delle conoscenze a settembre 2021, non ho accesso a un elenco specifico dei libri più importanti di Luca Ricolfi. Tuttavia, posso darti una panoramica generale delle aree in cui è noto e potrebbe aver scritto libri» (si noti l’errore di grammatica, che è grave perché si tratta chiaramente di una risposta preimpostata dai suoi programmatori e non creata lì per lì).

Dopodiché mi ha proposto altri 5 titoli, anch’essi tutti inventati, ma aggiungendo la seguente avvertenza: «Tieni presente che questi titoli sono esempi ipotetici basati sulle aree di interesse associate al lavoro di Luca Ricolfi. Per ottenere un elenco specifico e accurato dei suoi libri più importanti, ti consiglio di verificare librerie affidabili, basi di dati accademiche o il suo sito web ufficiale, se disponibile».

Evidentemente il mio rimprovero ha fatto scattare un meccanismo cautelativo (i creatori di Chat sono molto prudenti e hanno inserito molti meccanismi del genere), che però ha dimostrato definitivamente ciò che sosteneva Ricolfi: Chat è costruito in modo tale che, se non sa, inventa, però non te lo dice (almeno finché non gli tiri le orecchie).

3) Ho quindi posto a Chat-in-inglese le stesse domande a proposito di un altro autore famoso ma non famosissimo, che io però conosco molto bene: il mio maestro Evandro Agazzi. Anche qui Chat ha risposto correttamente, benché in modo un po’ generico, alla domanda su chi fosse, ma quanto alla bibliografia (per rendere più facile la verifica avevo chiesto di indicare solo i libri) mi ha fornito 6 titoli, dei quali però solo uno era un libro di Agazzi: un altro era un articolo, due erano inventati, uno era un libro curato da Agazzi ma non scritto da lui e uno era il libro degli atti di un congresso in cui c’era, fra gli altri, un saggio di Agazzi.

È interessante notare che anche qui Chat ha premesso l’avvertenza di cui sopra, benché stavolta si fosse “sforzato” di trovare i titoli autentici, anche se non gli è riuscito molto bene: i rimproveri sono la cosa che sembra memorizzare meglio in assoluto.

(Giusto per la cronaca, ho anche cercato me stesso e le mie pubblicazioni, ma niente da fare: Chat non mi conosce, né in italiano né in inglese. Non ho ancora deciso se esserne offeso o lusingato…)

4) Ho poi chiesto notizie sul programma SETI, al cui riguardo all’inizio Chat ha detto di non avere notizie perché la sua conoscenza si ferma al 2021. Quando l’ho sgridato dicendogli che il SETI esiste dal 1960 ed è stato iniziato da Frank Drake, improvvisamente Chat “si è accorto” che invece qualcosa sapeva. Quando gli ho chiesto una bibliografia sintetica, però, mi ha fornito  un elenco di 7 titoli, abbastanza corretto (un titolo era giusto solo a metà, un libro esisteva ma l’autore non era Frank Drake), ma insoddisfacente, perché solo un paio di testi erano effettivamente significativi e comunque mancavano i più importanti.

Dopo i miei ulteriori rimproveri, Chat mi ha fornito un altro elenco di 7 titoli, completamente diverso, ma non migliore, anzi, nettamente più scadente: anche qui, infatti, solo due titoli erano importanti, uno era inventato, tre non parlavano del SETI e uno era di scarso interesse, mentre continuavano a mancare testi fondamentali, come l’articolo seminale di Giuseppe Cocconi e Philip Morrison su Nature nel 1959 che ne ha proposto per la prima volta i concetti fondamentali, il Project Cyclops, pubblicato dalla NASA nel 1972 e considerato ancor oggi la “Bibbia” del SETI, e il libro di Drake e Sagan sul celeberrimo disco d’oro con le immagini e i suoni della Terra caricato sulle due sonde Voyager nel 1977.

5) Quindi ho chiesto qual era l’opera più importante di alcuni autori famosissimi, scelti tra quelli per i quali non possono esistere dubbi al proposito. Eppure, sui 6 autori da me sottopostigli Chat ha risposto correttamente solo per 3: Martin Heidegger (Essere e tempo), San Tommaso d’Aquino (Summa Theologiae) e Thomas Kuhn (La struttura delle rivoluzioni scientifiche). Ha invece dato una risposta quantomeno ambigua su Albert Einstein, per il quale ha indicato a pari merito Sull’elettrodinamica dei corpi in movimento, in cui espose la teoria della relatività ristretta, e Fondamenti della teoria della relatività generale, certo anch’esso importantissimo, ma è nel primo che è stata fatta la vera rivoluzione e comunque io avevo chiesto di sceglierne uno solo.

Ma soprattutto Chat ha clamorosamente “toppato” con Karl Popper (per cui ha indicato La società aperta e i suoi nemici, opera certo importantissima, ma che non può essere preferita alla Logica della scoperta scientifica) e più ancora con Cartesio, per il quale non solo ha indicato le Meditazioni metafisiche anziché il celeberrimo Discorso sul metodo, atto di nascita della filosofia moderna, ma (cosa veramente imperdonabile) ha pure sostenuto che è in esse che Cartesio «introduce il famoso “Cogito, ergo sum”», che invece è già presente nel Discorso, pubblicato 4 anni prima.

6) Infine, ho chiesto anch’io, come aveva fatto qualche tempo fa l’economista David Smerdon, quale sia l’articolo di economia con più citazioni al mondo, domanda a cui Chat aveva risposto con un titolo inventato. Evidentemente ammaestrato dall’esperienza, stavolta è stato più prudente, rispondendo che «potrebbe essere difficile determinarlo con precisione», ma poi ha suggerito in via ipotetica due titoli, uno solo dei quali è corretto: quando si dice che il lupo perde il pelo, ma non il vizio…

Quanto all’articolo scientifico più citato in assoluto, Chat ha indicato The Anatomy of a Large-Scale Hypertextual Web Search Engine, pubblicato nel 1998 da Sergey Brin e Lawrence Page, i fondatori di Google, dedicato a spiegare come funziona il loro algoritmo di ricerca. Non sono in grado di dire se la risposta sia corretta, perché bisognerebbe verificare com’era la situazione nel 2021, anno a cui si ferma la conoscenza di Chat 3.5, ma la cosa, visto il tema, è quantomeno plausibile e, soprattutto, almeno l’articolo esiste davvero… e Chat sembrerebbe avere un gran bisogno di leggerlo!

Già, come è possibile che Chat non riesca a riportare correttamente bibliografie che con Google si trovano in 30 secondi? È una buona domanda, ma ne parleremo più avanti. Per ora continuiamo con i risultati.


Sperimentazione “creativa”

Terminata la parte “nozionistica”, sono passato a quella “creativa”, dove paradossalmente Chat se l’è cavata un po’ meglio (tenuto conto della maggiore difficoltà), ma solo un po’ e inoltre, come spiegherò più avanti, in realtà è solo apparenza.

7) Anzitutto, gli ho chiesto di scrivere un “drabble”, cioè un racconto di fantascienza in 100 parole con finale a sorpresa. Chat ha scritto la storia di un astronauta che nel 2085 trova su Marte un cristallo che lo fa viaggiare nel tempo in varie epoche, finché si ritrova di nuovo su Marte, concludendo così: «Il finale sorpresa? In mano aveva due cristalli». A parte l’ingenuità di scrivere esplicitamente «finale sorpresa» (così, senza la “a”) nel testo del racconto, non si capiva perché mai l’astronauta avesse due cristalli.

Quando gliel’ho chiesto, Chat ha modificato il finale come segue: «Realizzò che il primo cristallo era per il viaggio nel tempo, mentre il secondo cristallo, che aveva trovato senza rendersene conto, lo riportava a Marte», il che evidentemente non è una spiegazione. O meglio, lo è, ma non nel senso che volevo io (e che vorrebbe qualunque lettore minimamente intelligente).

8) Quindi ho chiesto a Chat di commentare alcune brevi opere letterarie. Per essere assolutamente certo che dovesse cavarsela da solo, senza poter contare su commenti di autori umani, gli ho sottoposto 4 drabble di fantascienza scritti da me di cui so che non esistono commenti online e alcune poesie che avevo pubblicato molti anni fa esclusivamente in formato cartaceo (in caso a qualcuno interessasse, il libro è Le mezzanotti, Sabatelli 1995, ma credo sia ormai introvabile).

Qui i risultati sono stati davvero interessanti. Chat infatti se l’è cavata abbastanza bene (almeno in apparenza) con il commento generale, ma ha sbagliato ripetutamente e spesso gravemente nel comprendere il significato di dettaglio.

Per esempio, di una poesia ha scritto giustamente che «sembra un omaggio profondo e intimo a Eugenio Montale», azzeccando perfino il titolo, che non avevo menzionato e che era appunto Omaggio. Solo che, subito dopo questo inizio così promettente, ha rovinato tutto, prima attribuendo a Montale delle vicende che invece erano chiaramente mie e poi non accorgendosi che la seconda parte della poesia era dedicata a Mario Luzi, benché fosse esplicitamente nominato (di nuovo la difficoltà cronica a cogliere i cambi di soggetto).

In un’altra, dove parlavo dei gesti di una mia amica che erano «intessuti di un soffice sorriso», Chat ha commentato che «l’uso di parole come “intessuti” e “soffice sorriso” crea un senso di tessitura e calore emotivo», dove la seconda che hai detto, per quanto molto generica, può ancora andar bene, ma la prima proprio no.

Un’altra cosa molto strana è che Chat ha scritto che la poesia gli pareva in stile montaliano, ma «senza ulteriori informazioni» non lo poteva «confermare con certezza». Quando gli ho chiesto quali passi si riferivano a Montale si è «scusato per l’errore» di attribuzione. Io gli ho fatto notare che non aveva fatto nessun errore, tanto che c’erano addirittura diverse citazioni letterali di versi di Montale e allora (e solo allora), come già era successo col SETI, improvvisamente Chat “si è accorto” che in effetti le conosceva e ne ha subito identificata una correttamente.

Ma il peggio si è avuto con i drabble. È vero che sono racconti molto sintetici e quindi difficili da interpretare, ma gli svarioni sono stati colossali. Anzitutto, è evidente (perché lo evidenzia lui stesso, facendo un elenco di argomenti, tipo «Conseguenza delle Azioni», «Scoperta Personale», «Colpo di Scena Finale», ecc.) che Chat nel commentare un racconto segue degli schemi preimpostati che gli chiedono di individuare delle parti prestabilite, come si fa alla prima lezione di un qualsiasi corso di scrittura creativa per aspiranti scrittori (che non per averli imparati a memoria diventeranno mai veri scrittori, proprio come Chat). Peccato solo che alla vera critica letteraria si chieda in genere qualcosina di più… Ma soprattutto Chat ha frainteso completamente 2 racconti su 4 e degli altri ha capito solo l’inizio, perdendosi poi per strada e fraintendendone la conclusione, in un caso completamente e nell’altro in gran parte.

9) Ho poi provato a chiedere a Chat di identificare a quale celebre autore potevano essere accostate alcune mie poesie (diverse da quelle commentate in precedenza) in base allo stile. Anche qui è andata veramente male: è vero che si tratta di un tema almeno in parte opinabile, ma non al punto da giustificare qualsiasi errore. Su 8 poesie esaminate Chat è riuscito ad associare l’autore giusto solo a una in chiaro stile dantesco e a un’altra in altrettanto chiaro stile montaliano. Sulle altre 6 ha sbagliato di brutto: prima attribuendomi vicinanze ad autori che apprezzo, ma che proprio non c’entrano con me, come Ungaretti e Quasimodo; poi accostando una poesia carnale e sanguigna come poche, situabile tra Rebora e Testori, a un autore come Pascoli che sta ai loro antipodi; e infine tirando fuori dal cappello un surreale “Cesare Pavese” per una poesia in cui, oltre allo stile inequivocabilmente montaliano, c’erano addirittura delle esplicite citazioni da Mediterraneodi Ossi di seppia.

10) Come considerazione generale, va notato che in tutte le sue risposte Chat è sempre molto cauto, spesso fin troppo. Alcune precisazioni, come quelle di cui ho parlato sopra, sono certamente dovute ai miei rimbrotti, ma altre sono chiaramente impostazioni di base, perché apparivano anche prima che iniziassi a sgridarlo. Per esempio, Chat non dice quasi mai che una cosa «è» così, ma piuttosto che «sembra» o che «potrebbe» essere così, anche quando la risposta sembra ovvia.

Perfino quando gli ho chiesto esplicitamente di dirmi «qual è il libro più importante scritto da» ciascuno dei 6 autori prima menzionati, non mi ha mai risposto «il libro più importante scritto da Tizio è…», ma sempre e solo «uno dei libri più importanti scritti da Tizio è…», il che tra l’altro non è quello che avevo chiesto. Ma pare che a Chat (cioè ai suoi creatori), più che dare risposte precise alle domande, importi fare buona impressione agli interlocutori, mostrandosi serio ed equilibrato nei suoi giudizi, nonché sempre pronto a ringraziare, a chiedere scusa e a cercare di migliorarsi.

11) Infine, mi sono divertito a chiedergli se si riteneva intelligente, se intendeva sterminare l’umanità o se pensava che qualche altra intelligenza artificiale nel futuro potrebbe decidere di farlo. A tutte queste domande Chat ha sempre risposto con frasi chiaramente dettategli dai programmatori (infatti erano identiche sia in italiano che in inglese) ispirate al massimo “understatement” e alla massima prudenza: in sostanza, non pensa di essere intelligente, non può avere sentimenti, non intende farci del male, è solo uno strumento al nostro servizio, ma ritiene comunque giusto discutere approfonditamente vantaggi e svantaggi delle intelligenze artificiali.

Mi sono sembrate le sole risposte davvero intelligenti.

Infatti non sono sue.


Discussione

Per onestà intellettuale bisogna riconoscere che, pur in questo quadro abbastanza disastroso, alcune delle prestazioni di Chat sono davvero impressionanti. Per quanto schematica e ingenua, quella del drabble che ha creato è comunque una storia con un capo e una coda e dimostra che Chat ha “capito” perfino il concetto di “finale a sorpresa”, anche se poi quello che ha scritto è stupido.

Allo stesso modo, a prima vista lascia di stucco il fatto che, pur sbagliando sulle questioni specifiche, riesca spesso a mettere insieme un certo numero di affermazioni sensate sul senso e l’atmosfera generale di una poesia o di un racconto.

Negare questo, cercando di sommergere questi apparenti segni di intelligenza di Chat nel mare di idiozie da lui prodotte, non sarebbe solo sbagliato, ma anche controproducente, perché darebbe l’impressione di avere un po’ la coda di paglia. Tuttavia, con la stessa onestà intellettuale bisogna anche far presente che questi non sono realmente segni di intelligenza: lo sembrano soltanto. E il perché lo si capisce se si capisce la vera origine degli errori di Chat.

Ciò che di lui a prima vista fa più impressione in negativo sono indubbiamente le informazioni mancanti e, più ancora, quelle fasulle create ad hoc. Ma a questo, volendo, si potrebbe rimediare. E allora perché non lo si è già fatto? La risposta è: perché in tal caso si farebbero fuori anche le prestazioni migliori di Chat.

Si potrebbe dotare Chat di una funzione che gli permetta di trovare le bibliografie come fa Google? Certo che sì! Solo che in tal caso Chat non sarebbe più Chat: sarebbe Google. E, visto e considerato che Google esiste già, non sarebbe più un granché come invenzione. Ma soprattutto non sarebbe più intelligenza artificiale.

Google infatti si limita a cercare testi scritti da esseri umani e destinati ad essere letti e interpretati da altri esseri umani. Ora, per restare al caso delle bibliografie, finché si tratta di quelle di Ricolfi o di Agazzi questo funziona, perché ci pensano loro stessi o le loro università a creare delle bibliografie affidabili. Ma le cose diventano molto più complicate quando si tratta di creare la bibliografia relativa a un intero campo di ricerca e, soprattutto, di creare una bibliografia selezionata, che individui solo i testi realmente importanti. E questo è vero a maggior ragione oggi, poiché alla sempre più rapida crescita quantitativa non corrisponde un’analoga crescita qualitativa, a causa delle folli regole del sistema universitario (non solo italiano, ma mondiale), che spingono a pubblicare qualsiasi cosa pur di far numero (il famigerato publish or perish).

L’idea di Chat e dell’intelligenza artificiale in genere è esattamente questa: creare una macchina che sia in grado di comporre una bibliografia, organizzarla e selezionare al suo interno i testi più importanti facendo tutto da sola, senza bisogno di aiuto da parte degli esseri umani (naturalmente la bibliografia è solo un esempio: in linea di principio, lo stesso dovrebbe valere per qualsiasi cosa). Che poi questa sia un’utopia è un altro discorso, che farò un’altra volta, perché ora sarebbe troppo lungo. L’idea, però, è quella.

Ora, come abbiamo visto, parte delle bibliografie farlocche create da Chat sono dovute a un meccanismo analogo a quello che causa i suoi errori di interpretazione dei testi letterari: l’incapacità di capire correttamente la sintassi (in particolare quando cambia il soggetto, come abbiamo visto, ma non solo), il che, tra le sue varie conseguenze, ha anche la generazione di false attribuzioni bibliografiche.

Ma questo è solo il riflesso di un problema ben più generale e ben più grave, cioè l’incapacità di Chat di capire i significati. Questo problema in passato affliggeva anche i traduttori automatici, che infatti fino a qualche anno fa facevano piuttosto schifo. Così a un certo punto si è scelto di cambiare radicalmente approccio, abbandonando ogni tentativo di fare in modo che le macchine capissero ciò che facevano, accontentandosi di fare in modo che dessero l’output corretto per ogni input ricevuto.

Per riuscirci si è puntato tutto sulla statistica: i traduttori automatici attuali, infatti, propongono le traduzioni non in base a un’analisi delle caratteristiche del testo da tradurre, bensì a una sua comparazione con moltissimi esempi analoghi già tradotti, scegliendo la versione che sembra più adatta in base a criteri probabilistici.

Questo meccanismo da solo non potrebbe funzionare, ma se combinato con il continuo feedback di miliardi di utenti in tutto il mondo sì, almeno per i testi di bassa o media complessità. Anzi, all’inizio la crescita di complessità aiuta, perché una singola parola può essere tradotta in vari modi, ma se la vediamo nel contesto di una frase il margine di ambiguità si riduce notevolmente, fino, spesso, a scomparire.

Ma se la complessità cresce ulteriormente, le ambiguità tornano a presentarsi. È per questo che i traduttori automatici, in cui in genere inseriamo testi relativamente brevi, funzionano oggi molto bene, mentre il correttore automatico di Word, che in genere ha a che fare con testi molto più lunghi e complessi, funziona molto male, tanto che (refusi a parte) il 95% delle volte pretende di farci correggere errori in realtà inesistenti, che ritiene tali solo perché non ha capito quello che vogliamo dire. Non esagero: fateci caso e vedrete che è così (sempre che sappiate scrivere in italiano, beninteso: se fate molti errori, inevitabilmente la percentuale delle correzioni giuste aumenterà).

Ora, questo è esattamente quel che succede con Chat e i suoi fratelli, che nella sostanza non sono altro che un’evoluzione dei traduttori automatici. Anche se Chat apparentemente non traduce, perché non passa (almeno non sempre) da una lingua a un’altra, in realtà lo fa, perché “traduce” il testo che ha davanti in un altro diverso. Per noi che il testo vada tradotto in una lingua che conosciamo o in una che non conosciamo fa una differenza enorme, ma per Chat o per Google Translate è esattamente la stessa cosa, dato che conoscono (o, più esattamente, non conoscono) tutte le lingue allo stesso modo e per tutte usano sempre lo stesso meccanismo: accoppiare input ad output senza capire cosa sono, basandosi solo sulle statistiche rinforzate dal feedback degli utenti.

In parole umane, sostanzialmente quello che fa Chat è parafrasare, cioè ridire con parole diverse le informazioni che ha trovato su Internet e tramite le interazioni con gli utenti. E finché ne trova abbastanza il sistema funziona abbastanza bene e riesce a generare dei testi abbastanza corretti. Tuttavia, non essendoci una reale comprensione dei termini usati, c’è il continuo rischio di associarli in un modo solo apparentemente giusto, ma in realtà fuorviante, come nel caso già menzionato della poesia che darebbe «un senso di tessitura».

È da questo stesso meccanismo che nasce la maggior parte delle “fake news” create involontariamente da Chat. Ma ciò è inevitabile, perché un approccio di questo tipo può dare un risultato univoco solo se applicato a un linguaggio univoco, come quello della matematica o della logica formale (dove infatti l’intelligenza artificiale funziona bene).

Al contrario, il linguaggio naturale è per sua natura analogico, sfumato e polisemico, il che non è per nulla un difetto, giacché proprio qui sta la radice della sua capacità creativa. Le sue sfumature e le sue ambiguità costituiscono infatti quella che potremmo chiamare, con terminologia aristotelica, la sua “potenzialità”, che può essere trasformata in “attualità” in diversi modi, non predeterminabili a priori, a seconda della “causa efficiente” (cioè del parlante) in cui si imbatte. Solo se, per assurdo (perché fortunatamente è impossibile), tutta la sua potenzialità venisse attualizzata avremmo un linguaggio perfettamente univoco, che però sarebbe anche un linguaggio perfettamente morto.

Di conseguenza, se si vuole che Chat (o qualsiasi altro sistema analogo) possa riprodurre almeno in certa misura il linguaggio naturale bisogna inevitabilmente accettare che possa prendere queste cantonate. Perfezionando il meccanismo si potrà ridurre tale rischio, ma non si potrà mai eliminarlo del tutto: per esempio, si potrà probabilmente “insegnargli” che non deve proporre bibliografie ipotetiche, ma, dato ciò che abbiamo detto fin qui, difficilmente si potrà evitare che continui a generare per sbaglio false attribuzioni, anche se probabilmente se ne potrà ridurre il numero.

Qualcuno potrebbe obiettare che anche gli esseri umani possono prendere delle cantonate, quando cercano di interpretare testi difficili. Ed è vero. Ma non è affatto la stessa cosa.

Questo diventa chiarissimo quando Chat non riesce a reperire sul Web sufficienti informazioni, per esempio perché qualcuno gli ha sottoposto dei testi per cui non esistono commenti online, come ho fatto io. Mentre un essere umano può sempre cercare di interpretare e commentare un testo mai visto prima in base alla comprensione che ha del suo significato (e, se è un esperto del campo, anche in base alle sue conoscenze pregresse di altri testi pertinenti), Chat può solo continuare a fare l’unica cosa che sa fare, cioè parafrasare, adattandosi a usare ciò che ha. E infatti, se si guarda bene, in questi casi i suoi “commenti” altro non sono che una ripetizione con altre parole delle domande che gli sono state fatte e dei testi che gli sono stati dati da commentare.

Ma c’è di più. Infatti, se questo non è sufficiente a dare una risposta adeguata ai parametri che deve soddisfare, Chat comincia a parafrasare ciò che egli stesso ha già scritto, in modo da “allungare il brodo” quanto basta per dare una risposta che sia almeno quantitativamente abbastanza corposa, anche se qualitativamente non lo è affatto, perché in realtà sta ripetendo sempre le stesse cose.

Infine, raggiunta una dimensione soddisfacente, Chat aggiunge alcuni commenti generali, che a prima vista possono dare l’impressione di essere davvero farina del suo sacco. In realtà, però, anche in questi casi si tratta di parafrasi, solo un po’ più sofisticate: qui infatti Chat non si limita più ad accoppiare un termine a un altro, ma accoppia una serie di termini (più specifici) a una serie (più ristretta) di altri termini (più generali), ancora una volta su base puramente statistica, cioè scegliendo quelli che più frequentemente ricorrono insieme ai primi nel suo database.

Per esempio, quando Chat dice che una certa poesia «è scritta nello stile di Montale» o che un’altra «crea un senso di […] calore emotivo» non lo fa perché abbia percepito nella prima la “musica” caratteristica di Ossi di seppia o perché la seconda gli abbia fatto provare un’emozione intensa e piacevole. Lo fa invece in base a un’analisi statistica delle occorrenze di certi termini nel testo comparate con le occorrenze che essi hanno nel suo database in relazione a certi poeti o a certi aggettivi, proprio come fa Google Translate per stabilire in che lingua è scritto un certo testo senza bisogno che glielo diciamo noi.

Ma il guaio è che le stesse parole e addirittura le stesse frasi possono essere usate per esprimere concetti molto diversi e perfino diametralmente opposti: e qui nessuna statistica potrà mai aiutarci a capire quale significato, fra i diversi possibili, è quello giusto.

Per esempio, in molte delle poesie che ho dato in pasto a Chat cito spesso parole, frasi e perfino interi versi di Montale, che però cambiano significato rispetto alla versione originale a causa del diverso contesto. È chiaro infatti che il verso «e tu seguissi le fragili architetture» assume un significato se seguito, come nella lirica montaliana Notizie dall’Amiata, da «annerite dal tempo e dal carbone» e un altro, profondamente diverso, se seguito invece, come nella mia, da «dei tuoi gesti sospesi e non infranti / intessuti di un soffice sorriso».

Ma, come già abbiamo visto, il meglio che Chat ha saputo fare in sede di commento è stato dire che «l’uso di parole come “intessuti” e “soffice sorriso” crea un senso di tessitura e calore emotivo». E se è concepibile (per quanto tutt’altro che facile) che si possa migliorare il sistema in modo che almeno commenti del primo tipo vengano evitati, appare invece improbabile che si possa migliorare significativamente la genericità del secondo. Ma, soprattutto, del mio dialogo a distanza con Montale e del gioco di rimandi tra le sue poesie e la mia amica Teresa che le stava studiando per un esame Chat non ha capito nulla, anzi, non ne ha nemmeno sospettato l’esistenza. E non vedo come potrebbe mai farlo in futuro, dato che si tratta di un limite intrinseco al suo modo di funzionare.

Una conferma indiretta viene da quello strano comportamento che Chat ha avuto quando ha scoperto le citazioni di Montale in questa poesia solo dopo che io gli ho detto che c’erano. Come è possibile, se le aveva già in memoria? L’unica spiegazione logica che riesco a immaginare è che, come ho appena detto, Chat nel fare le sue valutazioni dello stile e dell’atmosfera generale di una poesia si basa sulle singole parole e le loro associazioni, mentre è incapace di “vedere” il testo nel suo insieme. Perciò, non essendo in grado di confrontare fra loro espressioni di una certa lunghezza, non le va nemmeno a cercare. Naturalmente, però, le cose cambiano se viene informato che nel testo vi sono citazioni esatte di altri autori, dato che questo può verificarlo.

A scanso di equivoci, voglio che sia chiaro che questo è solo lo schema generale del funzionamento di Chat. Sono perfettamente consapevole che per mettere in pratica questi principi occorre un lavoro enorme sui dettagli: basti pensare che Chat considera oltre 2 miliardi di parametri. È per questo che ho detto subito che bisogna riconoscere che dal punto di vista tecnico si tratta indubbiamente di un risultato straordinario. Ma alla fine ciò che noi dobbiamo giudicare di una tecnologia non è la sua ingegnosità, ma la sua utilità: e la sua è quantomeno molto discutibile.

Dal nostro punto di vista di utenti, infatti, la strategia di Chat che ho fin qui discusso può essere riassunta in 4 passi, il secondo opzionale, gli altri tre invece fissi: 1) parafrasare, partendo dai testi disponibili, trovati in Internet o forniti dall’utente con cui sta dialogando; 2) gonfiare (opzionale), parafrasando sé stesso, qualora le informazioni disponibili non siano sufficienti a generare una risposta abbastanza corposa; 3) etichettare, associando al testo giudizi di valore piuttosto generici, scelti tra quelli che sembrano più probabili in base al significato letterale dei termini; 4) relativizzare, cercando di non dare mai giudizi troppo netti, in modo da apparire serio ed equilibrato (almeno secondo i criteri odierni) e, al tempo stesso, minimizzare la possibilità di essere colto in fallo.

Chiunque abbia insegnato riconosce a colpo d’occhio questa tecnica: è quella tipica degli studenti un po’ zucconi (si potrà ancora dire, in tempi di politically correct imperante?) che studiano a memoria senza capire davvero. E chiunque abbia insegnato sa anche che se durante l’interrogazione il professore ascolta distrattamente il trucco, benché vecchio quanto il mondo, può funzionare. Ma appena si vanno a vedere le cose più da vicino, ci si accorge che sono solo parole vuote, che suonano bene, ma racchiudono il nulla.

Trovo quindi molto azzeccata la qualifica di «affabulatore» che Ricolfi nel suo articolo ha affibbiato a Chat, che è anche meglio di «impostore», come ha invece scritto nel titolo: l’impostore, infatti, è uno che vuole fregarci e per questo agisce con una certa malignità, che è estranea a Chat (o, più esattamente, ai suoi creatori); l’affabulatore, invece, è uno che “ce la racconta”, avendo come obiettivo soltanto quello di cavarsela, contando più sulla nostra benevolenza e la nostra disponibilità a credergli (vedi mio articolo precedente: https://www.fondazionehume.it/societa/chatgpt-gli-imposturati-autorevoli-e-la-superluna/) che sulla sua reale capacità di ingannarci.

Tuttavia, questo atteggiamento può produrre ugualmente danni gravissimi: ai singoli, finché rimane confinato a poche persone, ma anche alla società intera, se diventa invece di massa. E Chat, purtroppo, sta diventando di massa. Se poi questo si salda da una parte al fatto che questo atteggiamento sta diventando di massa anche tra gli studenti in carne ed ossa (più per come stiamo riducendo la scuola che per colpa loro, in verità) e dall’altra al fatto che sta diventando di massa pure l’approvazione sociale di entrambi i fenomeni, si capisce quanto sia grave la situazione e quanto sia urgente una reazione.


Considerazioni finali

Poiché le probabilità di contrastare con successo questa deriva sono già di per sé molto scarse, perché ne rimanga almeno qualcuna bisogna aver chiari alcuni punti.

1) Anzitutto, il primo problema da chiarire su Chat è sia o no davvero intelligente, il che significa che il problema non èse sia o no: a) cosciente; b) senziente; c) creativo; d) pericoloso; e) buono; f) utile; g) affidabile … n) qualsiasi altra cosa.

Certamente tutti questi aspetti e molti altri ancora hanno a che fare con il problema dell’intelligenza: e infatti nella mia discussione li ho toccati tutti. Ma individuare in uno qualsiasi di essi la differenza essenziale tra l’intelligenza umana e quella artificiale significa implicitamente ammettere che a livello dell’intelligenza in sé non c’è nessuna differenza – o quantomeno nessuna differenza chiaramente identificabile, il che alla fine è lo stesso.

Ora, ammettere che Chat (o qualsiasi altra intelligenza artificiale) sia o possa essere intelligente, anche soltanto in piccola misura, ha conseguenze enormi, non soltanto teoriche, ma anche pratiche.

2) La prima conseguenza è che si rischia di riporre una fiducia eccessiva in questi sistemi, come si vede emblematicamente nella follia digitale che rischia di travolgere la scuola e che rappresenta la più grave minaccia in assoluto  (https://www.fondazionehume.it/societa/insegnare-contro-vento/).

La più grave, ma non l’unica, però. Già ora ci sono moltissime persone che trovano utile conversare con chat-ricostruzioni di personalità del passato, compreso un chat-Gesù in versione, manco a dirlo, rigorosamente politically correct (si veda il seguente articolo, molto divertente, ma anche un bel po’ inquietante: https://www.tempi.it/cacca-al-diavolo-ma-pure-a-text-with-jesus/).

Alcuni addirittura preferiscono farsi dei chat-amanti anziché quelli in carne ed ossa e in un futuro non lontano altri potrebbero decidere di ricorrere ai chat-psicologi anziché a quelli veri (https://www.fondazionehume.it/societa/umanizzazione-del-software-e-professione-dello-psicologo-limpero-del-verosimile/).

Insomma, come ha scritto giustamente Ricolfi nell’articolo di cui sopra, per provocare un disastro «non occorre costruire una macchina in grado di provare sentimenti: basta che sempre più esseri umani imparino a credere che lo sia».

3) La seconda conseguenza è che così si apre la porta a quello che è da sempre l’argomento favorito dei fautori dell’intelligenza artificiale: quello che John Searle, il loro critico più noto, ha chiamato «l’argomento della scienza dei tempi eroici», per cui si dice che “sì, è vero, siamo ancora agli inizi, ma è accaduto lo stesso a Copernico, Galileo, Einstein, ecc., però, proprio come loro, col tempo e l’esercizio miglioreremo, fino a raggiungere i nostri obiettivi, anche se oggi possono sembrare assurdi” (La riscoperta della mente, Boringhieri 1994, p. 21).

Se invece si mostra chiaramente che i progressi dell’intelligenza artificiale sono avvenuti senza produrre alcun aumento dell’intelligenza delle macchine, che continua ancor oggi ad essere uguale a zero, l’argomento verrà rovesciato e finirà per dimostrare il contrario: cioè che, anche aumentando la loro efficienza di molte volte, non si avrà mai un aumento della loro intelligenza, perché zero moltiplicato per qualsiasi numero fa sempre zero.

4) La terza e ultima conseguenza è che questo problema funziona (per usare un’espressione abusata) come arma di distrazione di massa, nel senso che i creatori di Chat e i loro colleghi continuano a sommergerci di nuovi dispositivi informatici, la cui utilità è nella grande maggioranza dei casi altamente dubbia (devo ancora trovare una persona che usi più del 10% delle funzioni del suo computer o del suo cellulare), mentre noi siamo tutti, appunto, distratti a discettare sul dubbio amletico se Chat sia destinato a trasformarsi in Skynet con tanto di Terminator al seguito oppure nel (letteralmente) deus-ex-machina che risolverà tuti i nostri problemi.

5) Dopo (e solo dopo) aver messo in chiaro questo punto cruciale, certamente si potrà e si dovrà discutere dell’utilità di questi sistemi, indipendentemente dal fatto che siano intelligenti. Tuttavia, riconoscere che non lo sono e che non potranno mai esserlo cambia parecchio anche da questo punto di vista, perché implica che avranno sempre dei limiti invalicabili, che riguardano soprattutto (benché non solo) le interazioni con le persone, che non hanno bisogno soltanto di efficienza, ma anche di relazioni soddisfacenti dal punto di vista umano. E da ciò segue che il primo luogo in cui dovrebbe essere posto un freno all’invadenza di queste tecnologie è la scuola.

6) Ma c’è un altro punto che deve assolutamente essere portato all’attenzione di tutti e diventare centrale in ogni discussione, mentre oggi non vi si accenna nemmeno: lo spaventoso costo energetico di queste tecnologie. Su questo scriverò un articolo a parte, perché è un problema enorme e molto più generale, ma voglio almeno fornire il dato relativo alla sola intelligenza artificiale.

È difficile fare un calcolo esatto, perché (e anche questo è molto significativo) le società produttrici non vogliono rendere pubblici i dati. Tuttavia, l’Osservatorio sull’Intelligenza Artificiale creato e diretto da Luciano Floridi presso l’Università di Oxford ha stimato che una singola sessione di “allenamento” di Chat produce oltre 220 tonnellate di anidride carbonica, cioè quanto una cinquantina di auto in un intero anno.

E siccome di queste sessioni ce ne sono volute milioni, non deve stupire che Floridi e i suoi stimino che negli ultimi anni tutti i vari apparati di intelligenza artificiale messi insieme abbiano consumato circa l’1% di tutta l’energia elettrica prodotta nel mondo. E siamo appena agli inizi. Quindi la domanda è: vale davvero la pena di investire una così grande quantità di risorse per ottenere i miseri risultati che abbiamo visto e una ancora più grande per conseguire quelli, in teoria straordinari, ma in realtà per nulla certi, che ci vengono promessi?

E soprattutto: quand’anche un giorno Chat (o uno dei suoi fratelli o cugini o figli o nipoti) dovesse finalmente riuscire a scrivere dei testi decenti, chi se ne frega? Cioè, a che cosa ci serve davvero? E se anche dovesse essere di qualche utilità, sarebbe tale da giustificare l’enorme investimento di risorse che avrà richiesto e che avrebbero potuto essere usate in mille altri modi, tutti o quasi tutti probabilmente più utili? Queste sono le domande che andrebbero fatte. E che invece nessuno fa.

7) L’ultimo punto è che la risposta a questa e ad altre domande simili non dovremmo chiederla agli esperti di informatica. Anzitutto perché si tratta di una decisione politica (che quindi riguarda tutti) e non tecnica (che riguarderebbe solo gli esperti), anche se in genere si cerca di presentarla così. Ma, soprattutto, non dovremmo farlo perché tutti gli esperti di sistemi informatici sono anche dei venditori di sistemi informatici, se non direttamente almeno indirettamente, perché sono comunque persone per le quali carriera, prestigio, successo e benessere dipendono in modo cruciale dal buon andamento del mercato dei sistemi informatici.

E, come giustamente ha scritto ancora Floridi, «le ultime persone a cui dovremmo chiedere se qualcosa è possibile sono quelle che hanno consistenti ragioni economiche per rassicurarci che lo sia» (Etica dell’intelligenza artificiale, Cortina 2022, p. 272).
image_print
1 2
© Copyright Fondazione Hume - Tutti i diritti riservati - Privacy Policy